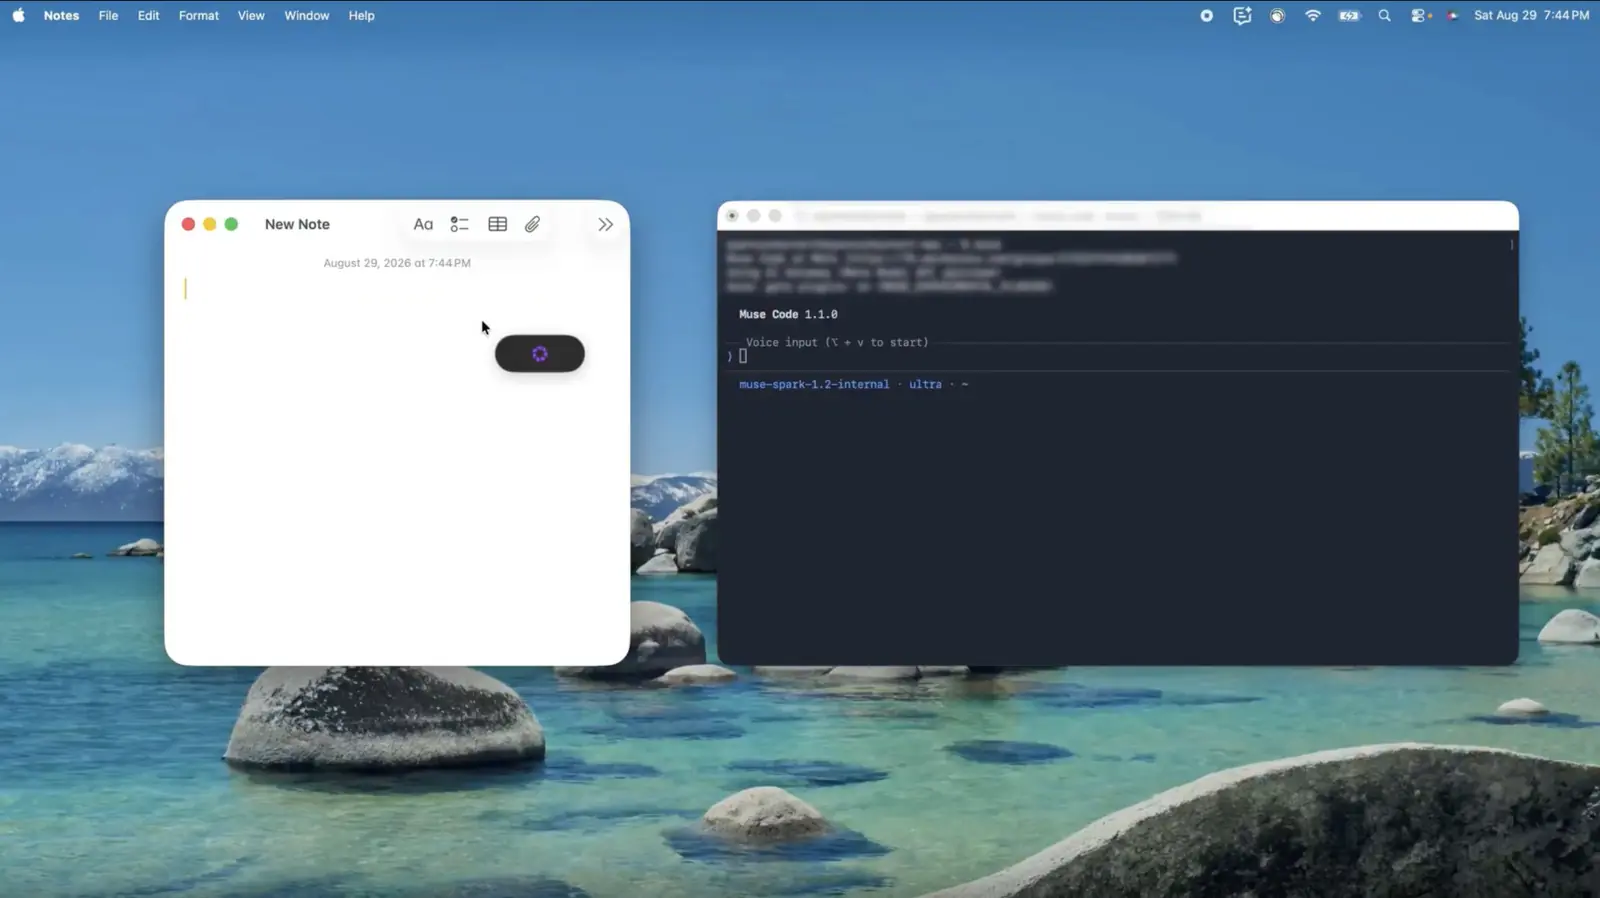
أعلنت ميتا عن إطلاق نموذج النسخ الصوتي الفوري Muse Voice Transcribe من مختبر الذكاء الخارق التابع لها. يتمتع النموذج بقدرة على التعامل مع إملاء ونسخ يتضمن أكثر من 20 متحدثًا مختلفًا، مع الحفاظ على السلاسة في التعامل مع لغات متعددة في الوقت ذاته.
أظهر الرئيس التنفيذي لميتا مارك زوكربيرج فيديو يوضح قدرات النموذج في التعامل مع السيناريوهات المعقدة. يستطيع النموذج تمييز المتحدثين المختلفين تلقائيًا والتبديل بينهم، كما يتمكن من التعرف على ظاهرة التبديل اللغوي وتحويل الجمل التي تجمع كلمات من لغات متعددة.
يعتمد النموذج على آلية تكيفية حيث يقرر متى يستمع، ويتأخر قليلًا عند الكلمات الصعبة ويسرع مع السهلة منها. تم تدريبه على أكثر من 70 لغة، مع التحقق من صحة 25 منها في مرحلة الإطلاق الأولى، ويتعامل مع جلسات تمتد لساعات كاملة تضم أكثر من 20 متحدثًا.
تأتي خطوة ميتا بعد أيام قليلة من إطلاق جوجل لنموذج Gemini 3.5 Transcribe الذي يتمتع بقدرات مشابهة. غير أن جوجل تدمج نموذجها في نظام أندرويد والمتصفح كروم، فيما لم تصرح ميتا بخطط واضحة لدمج نموذجها في خدماتها الرئيسية.
يمكن للمستخدمين حاليًا تجربة إمكانيات النموذج عبر تطبيق Meta AI على أجهزة ماك، الذي يدعم ميزات موجهة للصوت في تطبيقات أخرى. كما أتاحت ميتا النموذج للمطورين عبر Muse Code وواجهة برمجة التطبيقات الخاصة بها بسعر 3 دولارات لكل 1000 دقيقة صوتية، مع نسخة تجريبية على مدونة أبحاثها.



التعليقات (0)
لا توجد تعليقات بعد. كن أول المعلّقين.