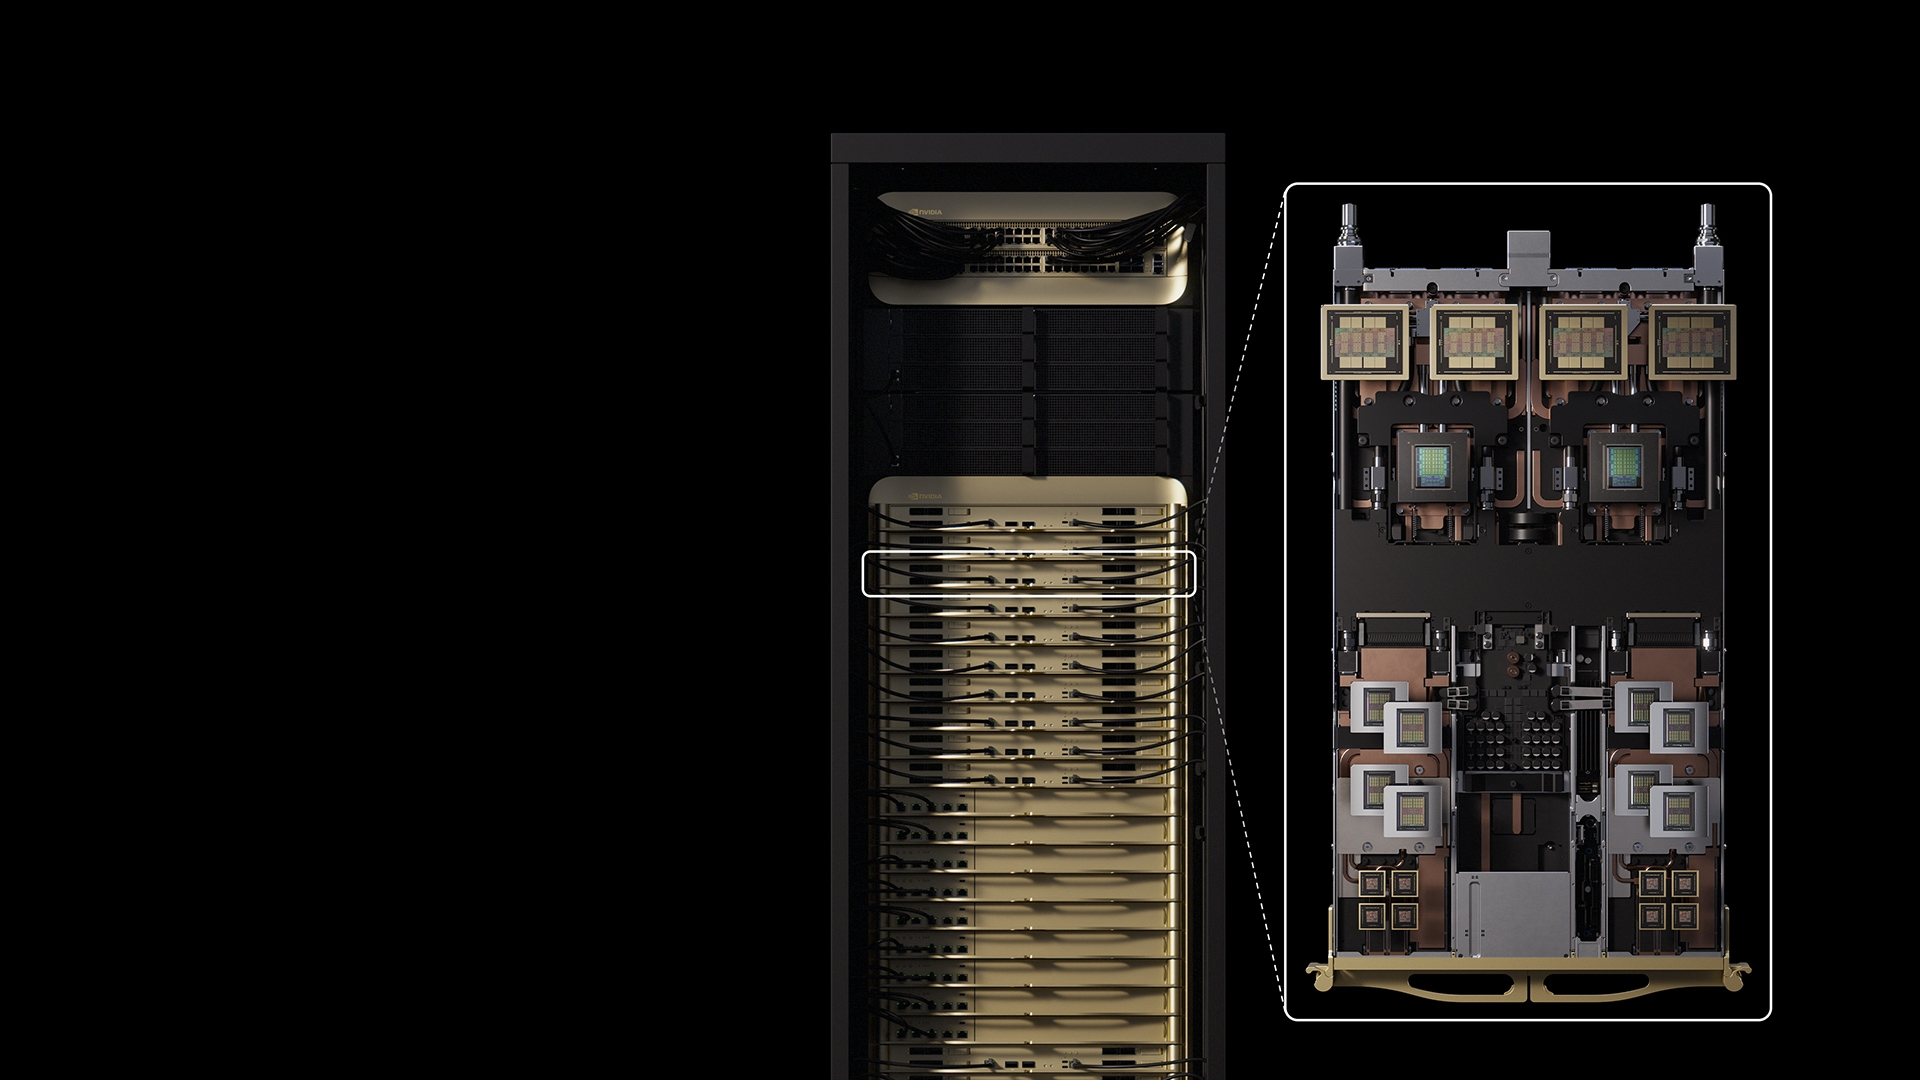
أعلنت NVIDIA في مؤتمر Hot Chips 2026 عن دخول معالج Groq 3 LPX مرحلة الإنتاج الكامل. يوصف المعالج بأنه "معجِّل استدلال ذكي تفاعلي"، ويعتمد على منصة Vera Rubin، وصُمّم لتوليد رموز فائقة السرعة لأنظمة الذكاء الاصطناعي الوكيلة. تخطط الشركة لإطلاقه خلال السنة الجارية.
تكتسب السرعة أهمية بالغة في تطبيقات الوكلاء الذكيين، التي تستهلك كميات ضخمة من الرموز عبر مئات أو آلاف خطوات الاستدلال. كلما زادت سرعة توليد الرموز، زادت عدد خطوات التفكير واستدعاءات الأدوات التي يمكن إنجازها في نفس الإطار الزمني. وهذا يسمح للأنظمة بتكرار العمليات بوتيرة أسرع داخل فترة الانتظار المقبولة للمستخدمين، مما يمكّن من كتابة واختبار الأكواد والتحقق من النتائج. تقول NVIDIA إن هذا يختصر مهام البرمجة من ساعات إلى دقائق.
أظهر معيار قياسي من Artificial Analysis أداء المعالج: حقق Groq 3 LPX على نموذج Gemma 4 31B بنافذة سياق تبلغ 100 ألف رمز معدل 3,400 رمز في الثانية، مقيسًا عبر 50 طلب متتالي. استقر الأداء بين 10 آلاف و100 ألف رمز من طول المدخلات. وفقًا لـ NVIDIA، يجعل هذا المعالج أسرع بأربع مرات من الخيار الثاني الأفضل، وهو معالج Cerebras، الذي حقق 882 رمزًا في الثانية.
لكن الخبراء يشيرون إلى تحفظات جوهرية. كل وحدة معالجة لديها 500 ميجابايت ذاكرة فقط، أقل بـ 576 مرة من وحدة Rubin GPU التي تملك 288 جيجابايت. هذا يعني أن النماذج تُقسَّم عبر عدة معالجات عبر شبكة إيثرنت. ونموذج Gemma 4 31B يمثل أفضل السيناريوهات، إذ يناسب رفًا واحدًا بالكامل. بينما نموذج DeepSeek V3 الأكبر يحتاج إلى أكثر من 1,300 معالج، أي نحو خمسة أرفف. كما تتجاهل المقارنة مع Cerebras عدد المعالجات المطلوبة: Cerebras تحتاج واحدًا أو اثنين فقط، بينما NVIDIA تحتاج 64 على الأقل. والمقارنة لا تأخذ في الاعتبار جيل Cerebras الأحدث CS-4 أصلًا.
التعليقات (0)
لا توجد تعليقات بعد. كن أول المعلّقين.