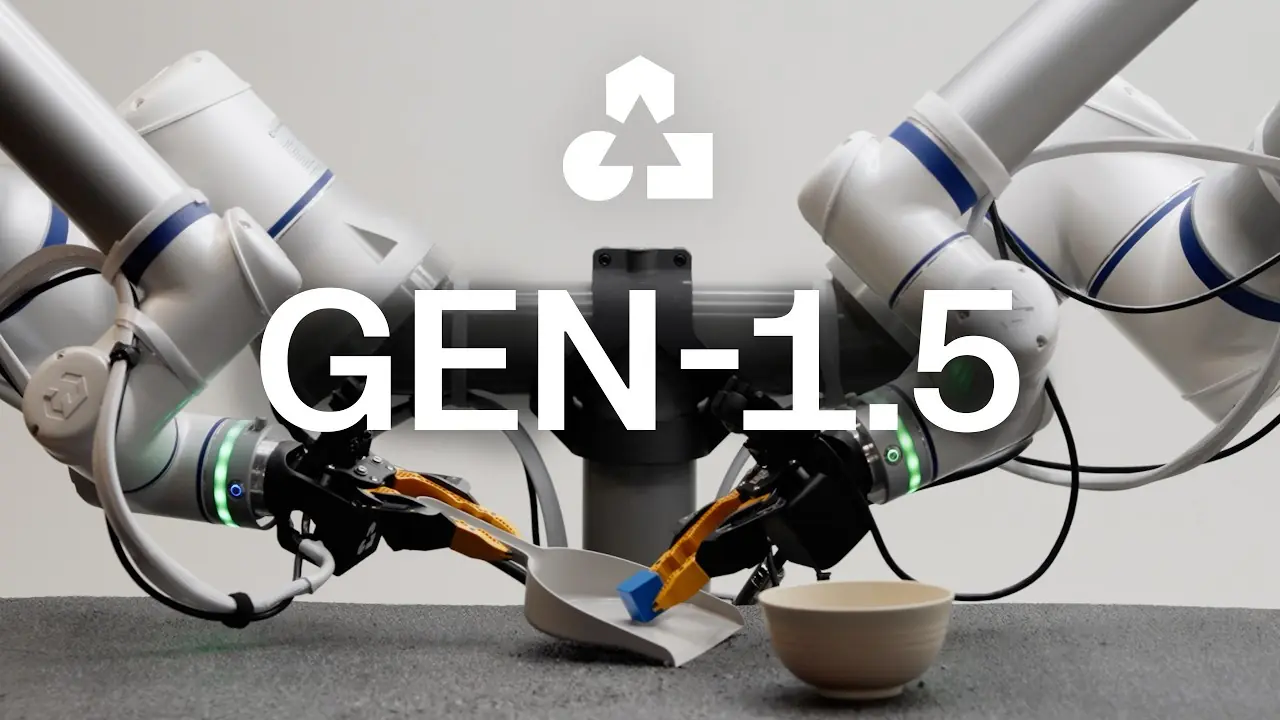
كشفت شركة Generalist AI، وهي متخصصة في مجال الروبوتات، عن نموذج ذكاء اصطناعي جديد يحمل اسم GEN-1.5، يتمتع بقدرة فريدة على تعليم الروبوتات مهام لم تؤدِها من قبل بناءً على عرض توضيحي واحد فقط.
يعتمد النموذج على تحميل مقطع فيديو قصير يتراوح بين 3 و12 ثانية ضمن سياق معالجته، ما يعمل بمثابة "موجه فيزيائي" يشابه الذاكرة قصيرة الأجل لدى الإنسان. وبعد ذلك، يباشر الروبوت تنفيذ المهمة دون الحاجة إلى أي تدريب إضافي. وفقًا لتقارير الشركة، حققت هذه الطريقة معدل نجاح بلغ 59 بالمئة عند اختبار عشر مهام مختلفة مثل فتح برطمان أو سحب أوراق نقدية من محفظة.
وعند إجراء عشر خطوات تدريبية باستخدام خمس دقائق من بيانات الفيديو، ارتفع معدل النجاح إلى 83 بالمئة. كما يستطيع النموذج ربط عرضين توضيحيين معًا لتنفيذ تسلسلات أطول، والاستفادة من عمليات محاكاة حاسوبية، ومحاكاة حركات اليد البشرية بشكل جزئي.
أشارت الشركة إلى أن هذه القدرات ظهرت بشكل تلقائي خلال مرحلة تدريب مكثفة استمرت أكثر من ثمانية أشهر على بيانات التفاعل المختلفة، ولم يتم تعليمها بصراحة للنموذج. وبينما أثبتت فرق بحثية أخرى إمكانيات مشابهة في التعلم السياقي في السابق، إلا أنها اقتصرت على عدد محدود من أنواع المهام. تؤكد Generalist AI أنها الأولى في تحقيق ذلك عبر نطاق واسع من المهام المختلفة.
مع ذلك، تجدر الإشارة إلى أن المهام المعروضة بسيطة وقصيرة نسبيًا، وأن جميع النتائج صادرة عن الشركة نفسها ولم تخضع للتحقق المستقل بعد.
Comments (0)
No comments yet. Be the first.