نجح باحثون من مختبر الذكاء الاصطناعي في جامعة بيركلي في توفير أول نظرية كاملة وقابلة للحساب لآلية عمل خوارزمية Word2vec، وهي الخوارزمية الرائدة في مجال تعلم تمثيلات الكلمات الكثيفة. تعكس هذه النتيجة فهماً جديداً لكيفية اكتساب الشبكات العصبية للمعرفة اللغوية من خلال نمذجة العلاقات الإحصائية في النصوص.
أثبت الباحثون أنه في ظروف عملية واقعية، تختزل عملية التعلم إلى تحليل مصفوفي وزني بسيط، وأن التمثيلات المتعلمة النهائية تطابق ببساطة المتجهات الذاتية الناتجة من تطبيق تحليل المكونات الرئيسية. تتسم ديناميكيات التعلم برتم متقطع ومتسلسل؛ في كل خطوة، تتعلم الخوارزمية مفهوماً خطياً جديداً واحداً، مما يزيد من رتبة مصفوفة التمثيلات بشكل تدريجي.
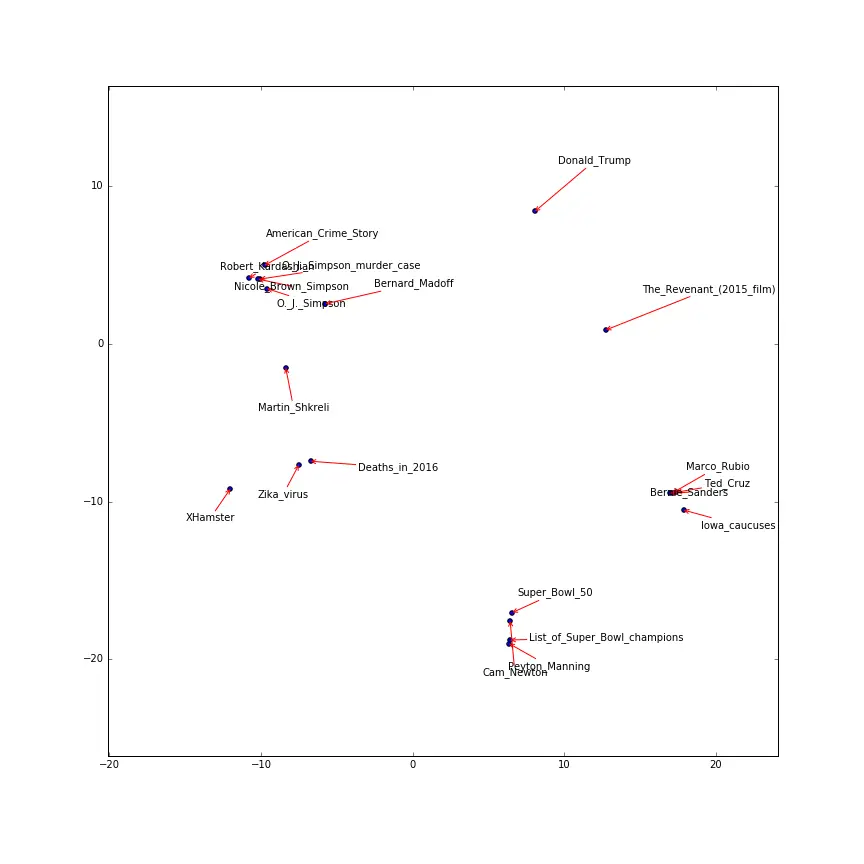
المصفوفة المستهدفة التي تحدد الميزات المتعلمة تُشتق حصراً من إحصائيات النص والمعاملات الخوارزمية، دون اعتماد على أي افتراضات توزيعية حول البيانات. اختبر الفريق نظريته على بيانات ويكيبيديا، فوجد أن المتجهات الذاتية الأولى تختار الكلمات المرتبطة بالسير الذاتية للشخصيات المشهورة، بينما تختار المتجهات الأخرى مفاهيم جغرافية وإدارية وغيرها قابلة للتفسير.
بالمقارنة مع الخوارزمية الأصلية، حققت النسخة التقريبية المدروسة 66% دقة في معيار إتمام التشابهات اللغوية مقابل 68% للنسخة الأصلية، ما يشير إلى أن التقريبات المستخدمة في النظرية معقولة وواقعية. اعتمدت التقريبات على تقريب رباعي للدالة الموضوعية، وقيود معينة على المعاملات الخوارزمية، وأوزان ابتدائية صغيرة جداً، شروط متوافقة مع الإعدادات الأصلية للخوارزمية.
طبق الباحثون نظريتهم على دراسة ظهور التمثيلات الخطية المجردة مثل مفاهيم الذكورة والأنوثة، مكتشفين أن الخوارزمية تبني هذه التمثيلات عبر خطوات تعليمية متسلسلة تتأثر بالضوضاء. يمثل هذا العمل خطوة مهمة نحو فهم أعمق لآليات تعلم الميزات في مهام معالجة اللغة الطبيعية، وقد يسهم في فهم أفضل للنماذج اللغوية الحديثة الأكثر تعقيداً.



التعليقات (0)
لا توجد تعليقات بعد. كن أول المعلّقين.