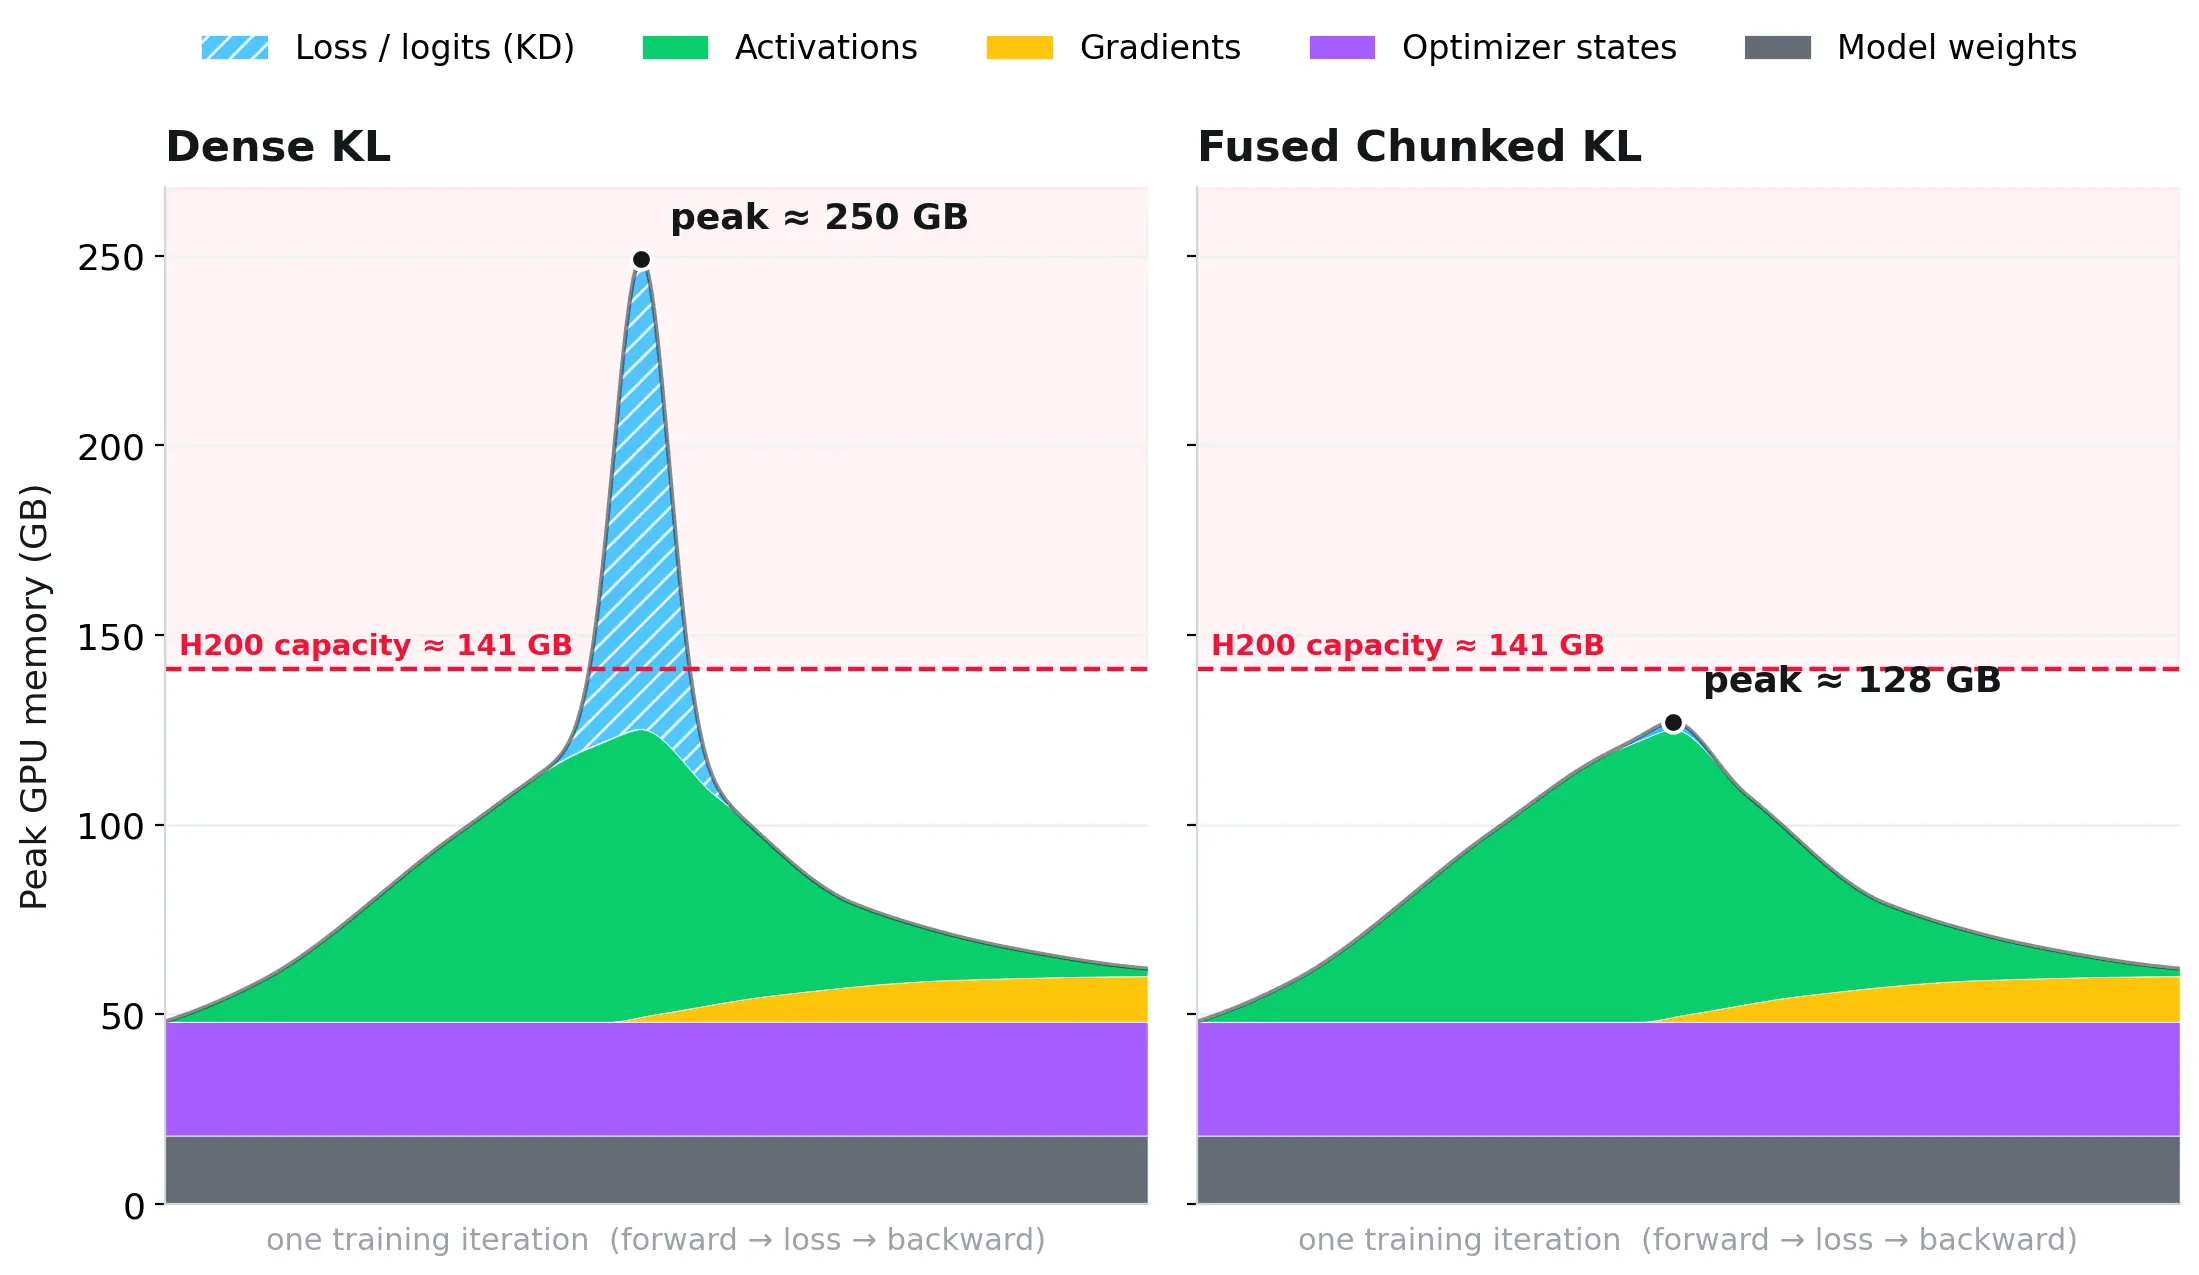
تعاني عملية تصغير النماذج اللغوية الكبيرة من تكاليف حسابية باهظة، إذ تتطلب الطرق التقليدية الاحتفاظ بالنموذج الكبير والصغير معًا في الذاكرة طوال عملية التدريب. نموذج gpt-oss-120b على سبيل المثال يحتاج وحده إلى نحو 50 جيجابايت من ذاكرة معالج واحد عند تسلسل بطول 32 ألف رمز، بينما تصل احتياجات التدريب الكلية إلى نحو 250 جيجابايت، وهو ما يفوق قدرة معالجات الذكاء الاصطناعي الحالية.
تقدم ورقة بحثية جديدة من Multiverse Computing حلين لهذه المشكلة. الأول يتمثل في حفظ المخرجات المتوقعة من النموذج الكبير مرة واحدة فقط، بدلًا من إعادة حسابها في كل خطوة تدريب، مما يحرر الذاكرة من الاحتفاظ بالنموذج الكبير أثناء عملية التدريب. الثاني يتعلق بصيغة محسّنة لدالة الخسارة المستخدمة تعالج البيانات على دفعات صغيرة متتالية بدلًا من بناء مصفوفة ضخمة تحتوي على المقارنة بين مخرجات النموذجين.
أظهرت الاختبارات أن هذين التعديلين يقللان استهلاك الذاكرة بمعامل يصل إلى 15.6 مرة عند تسلسلات طويلة. في تطبيق عملي لتصغير نموذج بـ 20 مليار معامل، انخفض الحد الأدنى من أربع وحدات معالجة إلى وحدة واحدة، وتسارعت عملية التدريب خمس مرات تقريبًا.
النموذج الصغير الناتج، المختزل من 8 مليارات معامل إلى 3.2 مليارات معامل، احتفظ بمعظم قدرات النموذج الأصلي في مهام الفهم العميق، وإن كان بانخفاض طفيف في الأداء على بعض المعايير المتخصصة.
أتاحت هذه الطريقة لفريق البحث إجراء تجارب واسعة النطاق على تصغير النماذج بتكاليف منخفضة، مما يجعل هذه العملية متاحة للعديد من الفريق البحثية والشركات بدلًا من أن تقتصر على من يملك موارد حسابية ضخمة. أطلقت الشركة أيضًا كود التطبيق مفتوح المصدر لاستفادة المجتمع البحثي.



التعليقات (0)
لا توجد تعليقات بعد. كن أول المعلّقين.