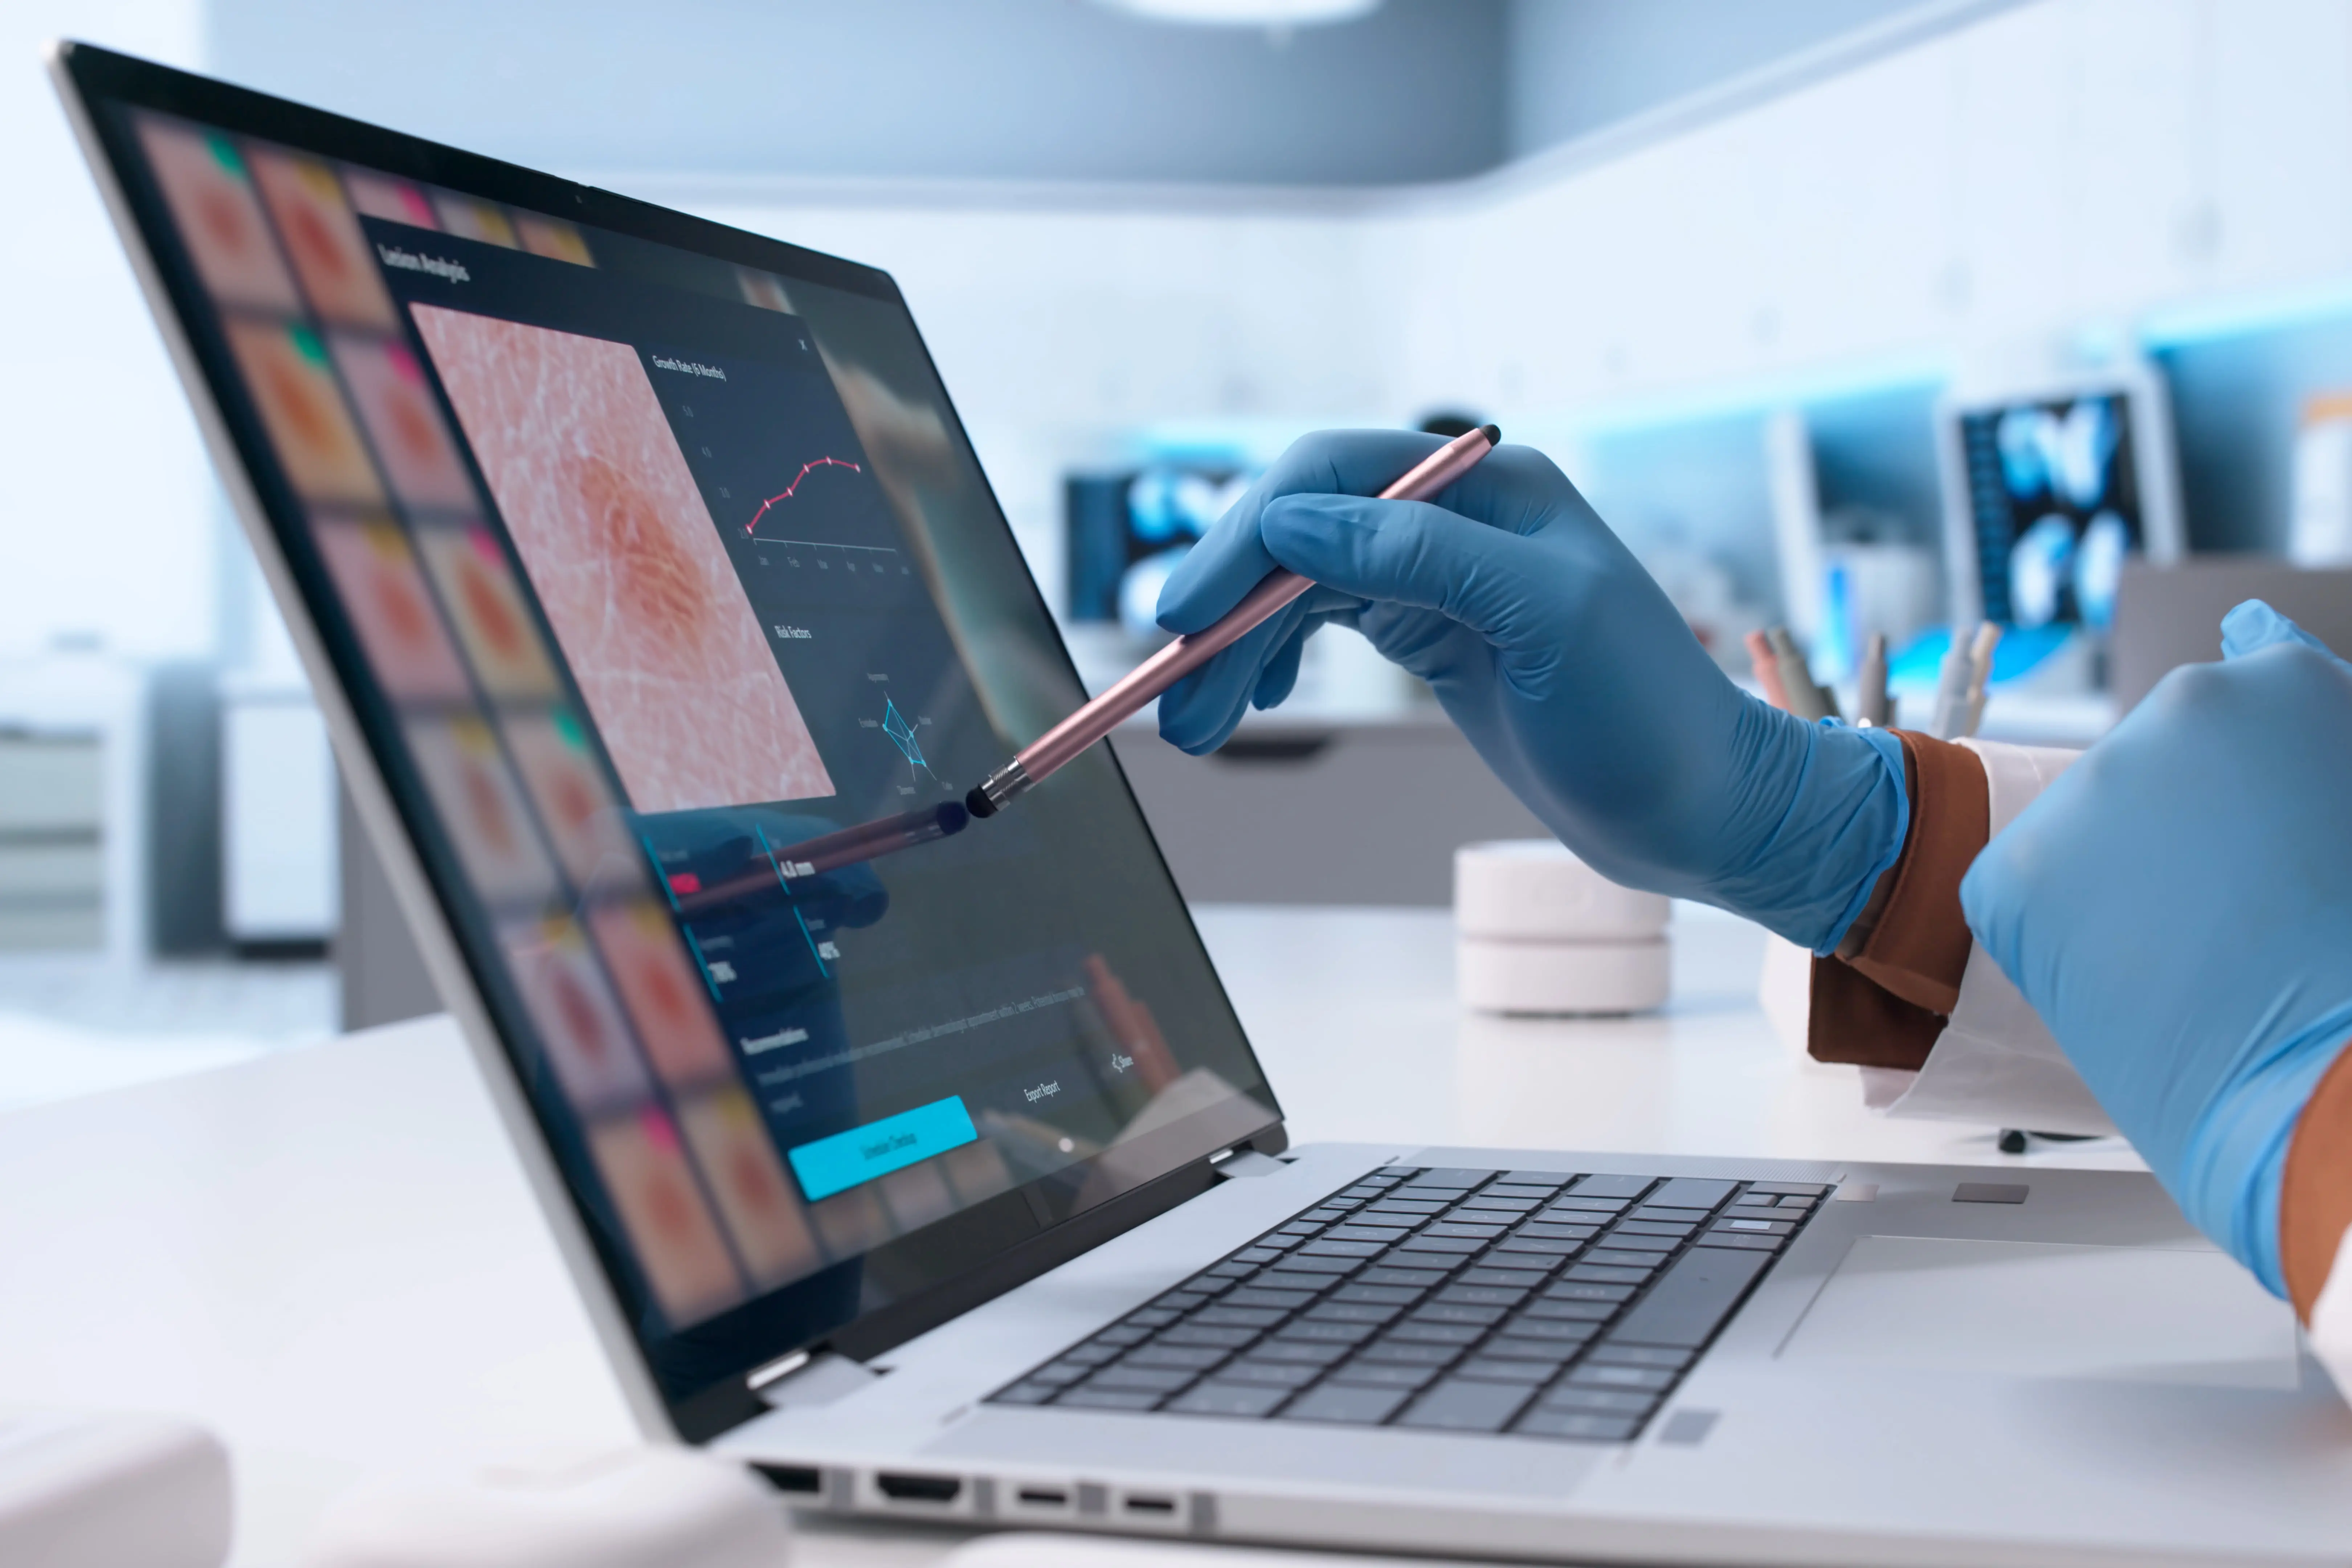
كشفت دراسة بحثية لمعهد ماساتشوستس للتكنولوجيا وشركاء آخرين أن تطبيق منهج موحد في تصميم أنظمة الذكاء الاصطناعي الطبية قد لا يحقق أفضل النتائج. فبينما تحسّن هذه الأنظمة دقة التشخيص لدى غير المتخصصين والعاملين في الرعاية الأولية، فإن طرق شرح قرارات الذكاء الاصطناعي تؤثر بشكل مختلف تماماً بحسب مستوى معرفة المستخدم.
قارنت الدراسة أداء غير المتخصصين والأطباء في تشخيص الأمراض الجلدية باستخدام عدة أساليب في الشرح الآلي للتنبؤات. ووجدت أن دقة غير المتخصصين تحسنت بشكل عام، لكن السبب الرئيسي كان اعتمادهم المفرط على توصيات النظام. فقد قبلوا شروح نماذج اللغة الكبيرة دون تمحيص، حتى عندما كانت خاطئة، وشعروا بثقة أكبر تجاه الإجابات الغامضة والعامة. أما الأطباء فلم يتأثروا بالتوصيات الخاطئة، بل حققوا أفضل النتائج عندما قدمت لهم تنبؤات النموذج دون شروح مصاحبة.
حذّر الباحثون من أن الأشخاص الأقل معرفة طبية هم الأكثر عرضة للانزلاق عندما يقدم النموذج توصيات خاطئة. وأشاروا إلى أن طريقة عرض التوصيات مهمة بقدر صحتها نفسه، حيث قد تساعد الشرح الواحد الخبير وتضلل المبتدئ. كما أن تقديم الشرح قبل محاولة المستخدم التشخيص بنفسه يزيد من اعتماده على النموذج.
وجدت الدراسة أيضاً أن استخدام نماذج مقيدة بمعايير إنصاف وتقلل التحيز ضد درجات لون البشرة الأغمق حسّن الدقة وقلل التفاوتات التشخيصية المتعلقة بلون الجلد. لكن الباحثين أوصوا بضرورة تشجيع التفكير الناقد لدى المستخدمين بدلاً من الاعتماد المفرط على شروح تفصيلية، مثلاً بطلب تشخيص أولي من المستخدم ثم تقديم اقتراحات الذكاء الاصطناعي كمساعد لاستكشاف احتمالات أخرى.
الدراسة التي نشرت في مجلة Nature Medicine تسلط الضوء على أهمية تصميم أنظمة الذكاء الاصطناعي مع الأخذ بعين الاعتبار خصائص المستخدمين، وتجنب الوقوع في فخ الاعتماد الآلي الذي قد يؤدي إلى أخطاء طبية خطيرة.
التعليقات (0)
لا توجد تعليقات بعد. كن أول المعلّقين.