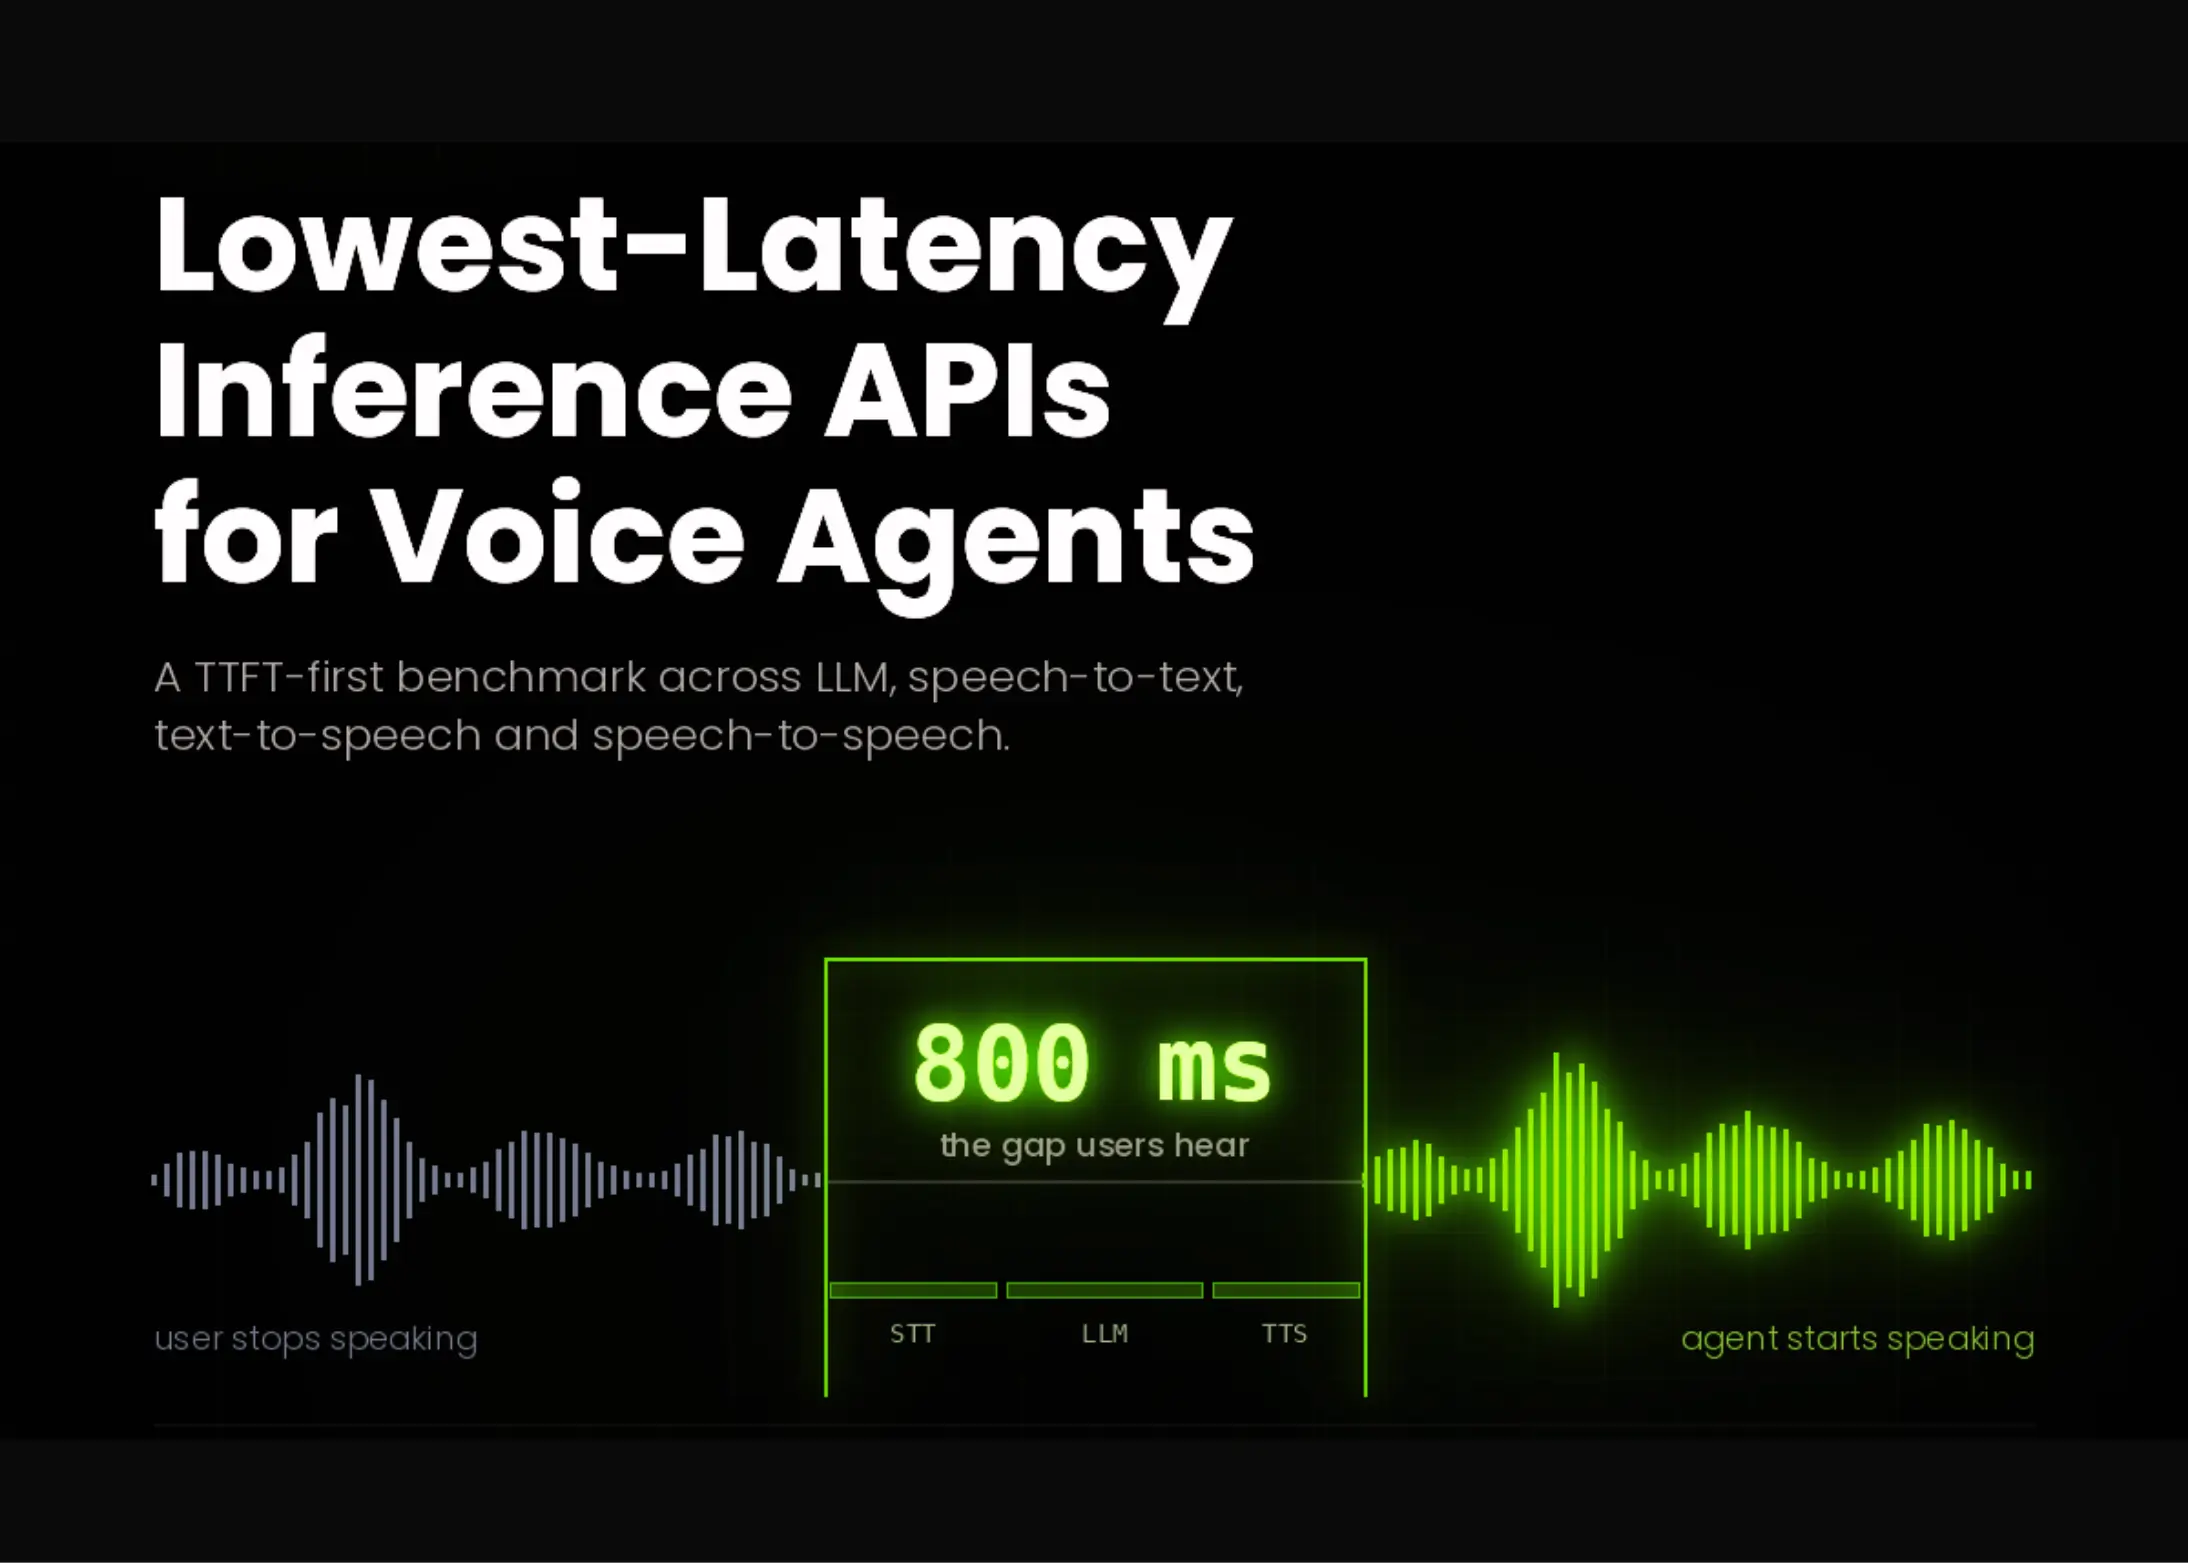
يعتمد فريق تطوير الوكلاء الصوتيين على مقياس زمن أول توكن (TTFT) لاختيار خدمات الاستدلال، غير أن هذا المقياس وحده لا يقدم الصورة الكاملة. في التطبيقات النصية، قد يكون كافيًا، لكن في الأنظمة الصوتية، يجب حساب عوامل إضافية. نموذج تحويل النصوص إلى كلام لا يستطيع إنتاج صوت قبل استقبال جملة كاملة، ما يعني أن الفترة بين بدء التوليد والإنتاج الفعلي للصوت حاسمة في جعل الوكيل يبدو طبيعيًا وقابلًا للحوار.
حددت الأبحاث أن متوسط وقت استجابة الإنسان في المحادثة يبلغ حوالي 500 ميلي ثانية، وتبدأ الفترات الصامتة الممتدة إلى 800 ميلي ثانية بالظهور بشكل غير طبيعي. لتحقيق محادثة طبيعية، يجب ألا يتجاوز الكمون الإجمالي من الكلام إلى الكلام 1.5 ثانية، مع توزيع الميزانية تقريبًا بين مراحل معالجة الوسائط والنقل والتعرف على الكلام ومعالجة النموذج اللغوي وتحويل النص إلى صوت.
تؤثر عدة عوامل على قراءات الكمون الفعلية، منها حجم مدخلات النموذج ومكان استضافة الخادم والاختلافات بين مصادر البيانات المستخدمة في القياس. على سبيل المثال، يظهر نفس النموذج (GPT-5.6 Luna) كمونًا مختلفًا عند التشغيل على Amazon Bedrock (0.59 ثانية) مقابل واجهة OpenAI الأصلية (0.74 ثانية). بعض الموفرين مثل LiveKit ينشرون بيانات مفصلة حول طرق قياسهم، مما يعزز مصداقيتهم.
في طبقة التعرف على الكلام، التحدي الأساسي ليس سرعة النسخ بل اكتشاف نهاية الجملة. تقدم خدمات مثل Deepgram Flux ميزات متقدمة تدمج كشف نهاية الدور مباشرة في نموذج التعرف، ما قد يقلل كمون الاستجابة بمقدار 200 إلى 600 ميلي ثانية.
فيما يتعلق بتحويل النص إلى صوت، تبالغ الشركات المصنعة غالبًا في تقدير أدائها. توضح ElevenLabs أن رقم 75 ميلي ثانية المذكور لنموذجها Flash v2.5 يشمل فقط وقت استدلال النموذج، دون احتساب التأخير في شبكة الإنترنت أو التخزين المؤقت قبل التشغيل. يكشف البحث أن الفجوة في جودة الصوت واضحة بين النماذج منخفضة الكمون والخيارات عالية الجودة، مما يجبر المطورين على الاختيار بين السرعة والجودة.
تمثل نماذج تحويل الكلام إلى كلام مباشرة محاولة لتخفيض الكمون بدمج التعرف على الكلام ومعالجة اللغة وتحويل النص إلى صوت في مسار واحد. غير أن هذه النماذج لا تضمن دائمًا أداءً أسرع من الحلول المعدلة بعناية.
Comments (0)
No comments yet. Be the first.