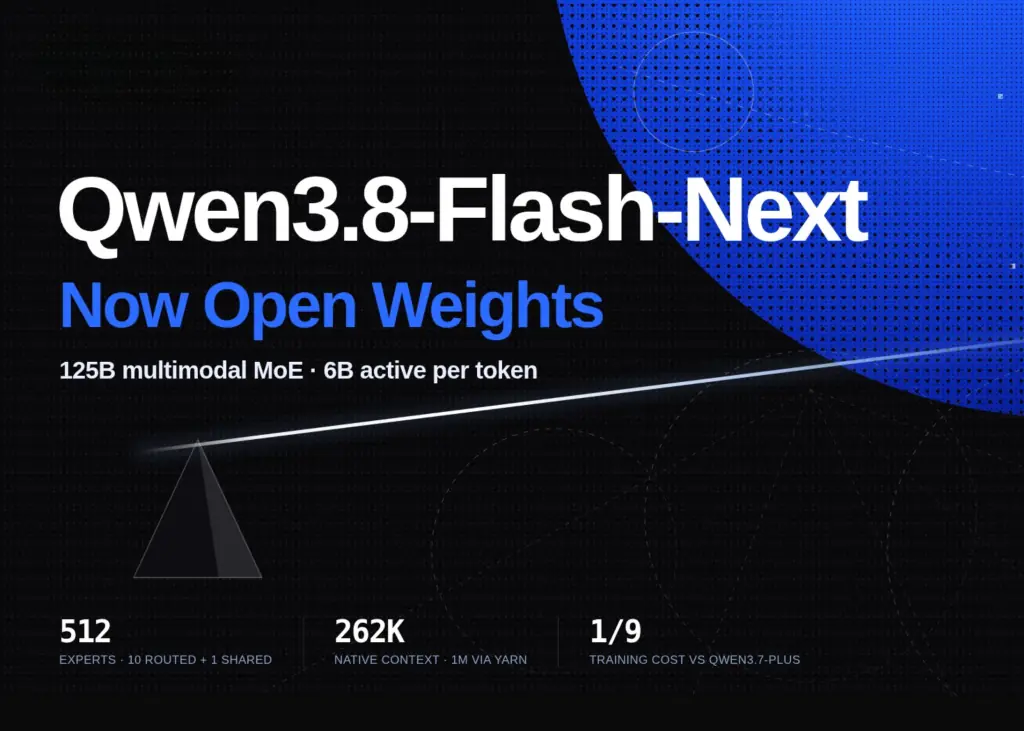
أعلنت مجموعة Qwen التابعة لعلي بابا عن إصدار نموذج Qwen3.8-Flash-Next، وهو نموذج متعدد الاستشعار يعتمد على معمارية خليط الخبراء المفتوحة الأوزان. يجمع النموذج بين عمود فقري يضم 125 مليار معامل وجدول تضمين N-gram بحجم 51 مليار معامل ووحدة تنبؤ متعددة الرموز بـ 4 مليارات معامل، بإجمالي 180 مليار معامل على القرص، لكن تفعيل 6 مليارات معامل فقط لكل رمز معالج.
يتضمن النموذج طبقة خليط خبراء بـ 512 خبيرًا، مع تفعيل 10 موجهة بالإضافة إلى خبير مشترك واحد، والمعمارية تستخدم هجينًا من بوابة DeltaNet وآلية الانتباه المتفرقة الخاصة بـ Qwen، مع محسِّن Muon جديد. أفادت المجموعة بأن تكلفة التدريب بلغت حوالي تسع مرات أقل من نموذج Qwen3.7-Plus السابق.
حقق النموذج نتائج قوية في مجالات متعددة: 58.7 في DeepSWE 1.1، و62.5 في SWE-bench Pro، و81.0 في SWE-bench Multilingual، و91.9 في LiveCodeBench v6. في المهام الموكلة سجل 73.9 في CoWorkBench و55.7 في JobBench. في المهام متعددة الاستشعار حقق 84.5 في AndroidWorld و88.5 في RealWorldQA و95.7 في MathVision مع مترجم الأكواد. بيد أنه لا يتصدر في جميع المقاييس، إذ يتفوق Claude Opus 4.6 عليه في بعض الاختبارات وDeepSeek-V4-Flash-0731 في اختبارات أخرى.
يتسع النموذج لسياق أصلي قدره 262,144 رمز، قابل للتوسع إلى مليون رمز باستخدام YaRN. يدعم النموذج عدة إطارات خدمة منها vLLM و SGLang و TokenSpeed و llama.cpp، مع إمكانية الضبط الدقيق عبر Unsloth و Swift و LLaMA-Factory. يعمل بالفعل في وضع "Standard" على QwenWork ويتوافق مع Qwen Code، مع تفعيل وضع التفكير الإضافي بشكل افتراضي.
Comments (0)
No comments yet. Be the first.