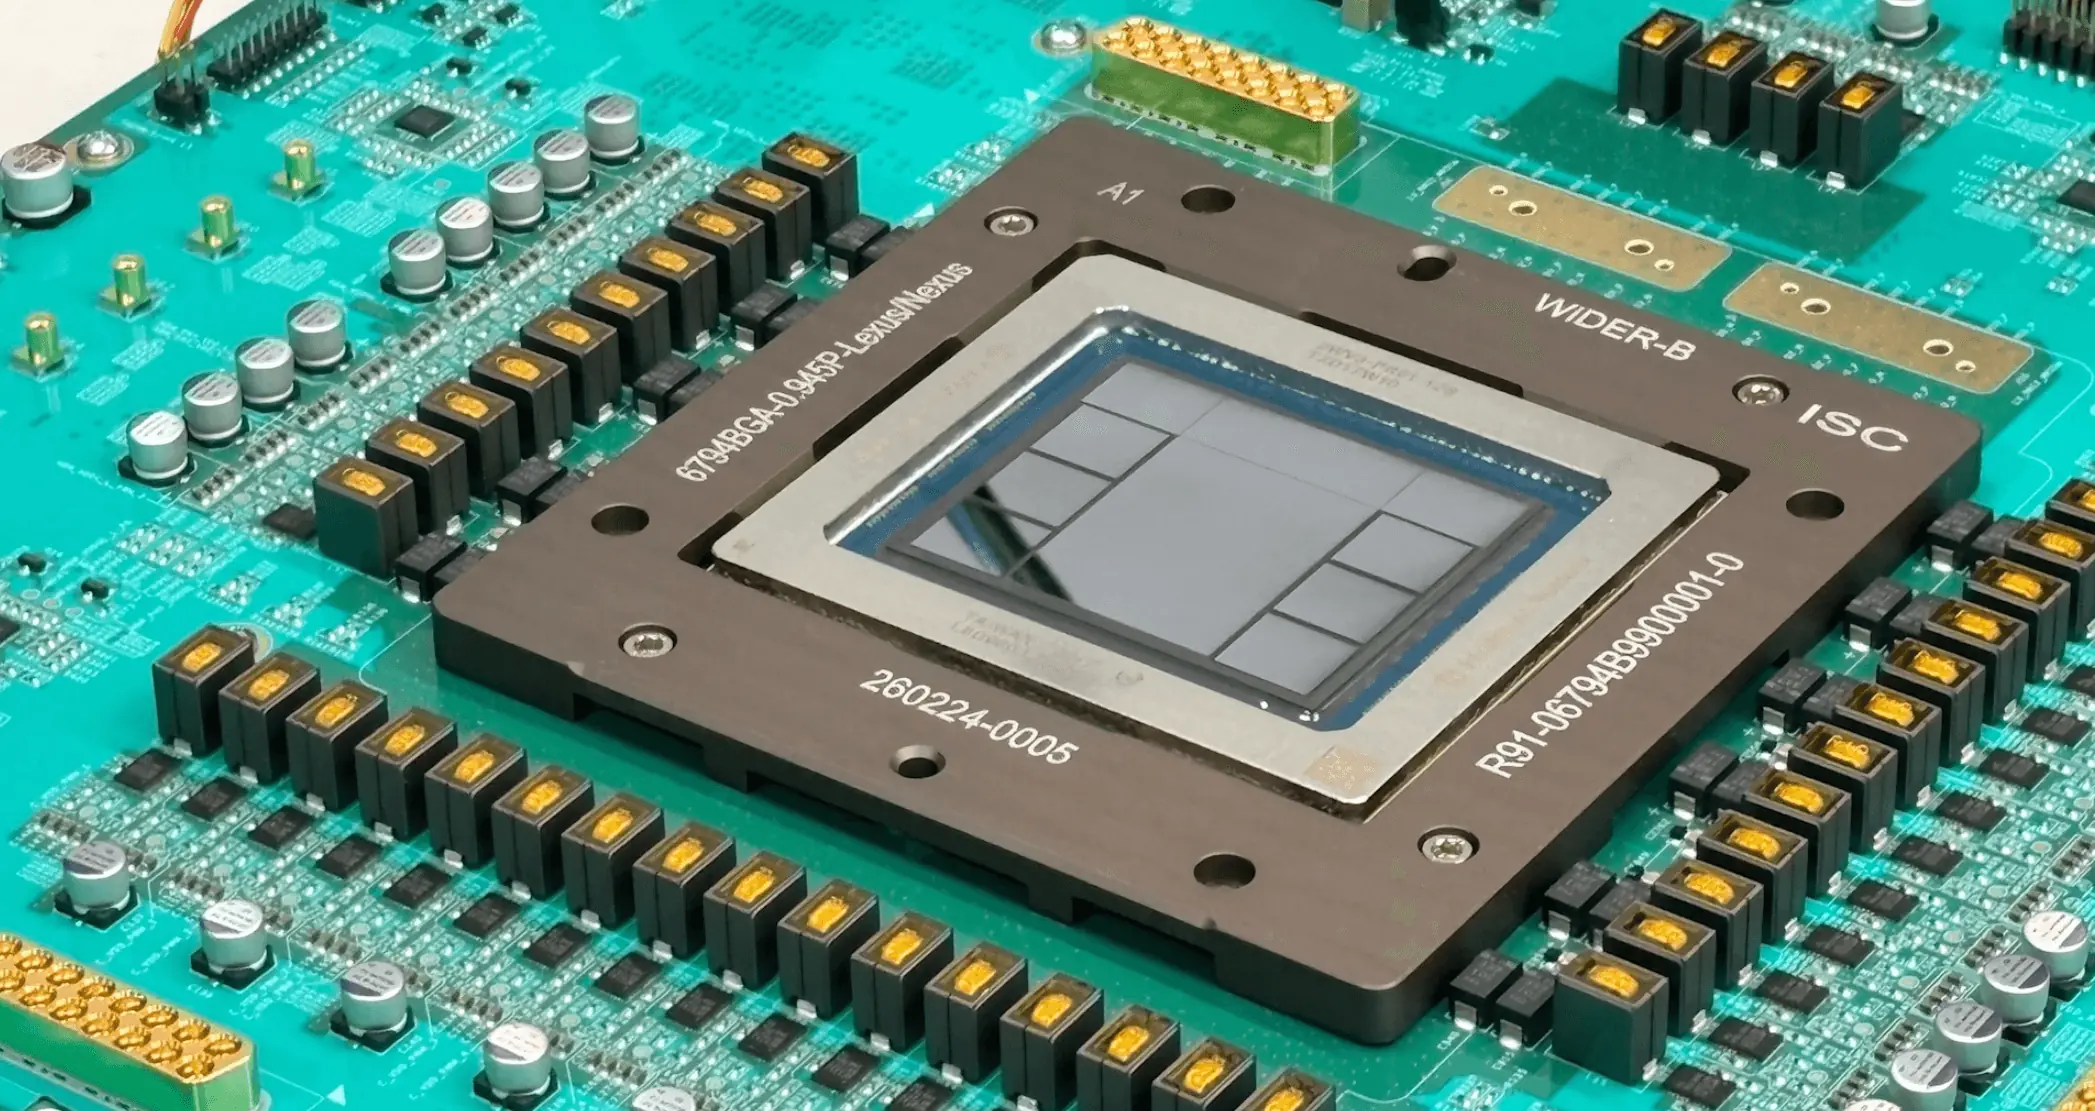
أعلنت OpenAI عن نتائج الاختبارات الأولى لرقاقة الاستدلال التي طورتها داخليًا بعنوان "Jalapeño"، والتي أسفرت عن تفوقها على معالجات Nvidia المختلفة في معايير الأداء الرئيسية. تركز الرقاقة على تشغيل نماذج الذكاء الاصطناعي فقط دون المشاركة في تدريبها، وهي معالج تسريع عام الغرض لنماذج اللغة الكبيرة.
حققت Jalapeño أداءً أفضل بمعدل 1.5 إلى 1.9 مرة من حيث كمية العمل لكل وحدة طاقة، وخفضت زمن الاستجابة بمعدل 1.7 إلى 3.6 مرات مقارنة بالأنظمة التجارية المتاحة حاليًا. في الأعمال التفاعلية، أظهرت الرقاقة أداءً أعلى بمعدل 2.1 إلى 4.1 مرات. اختبرت النتائج على ثلاث نماذج: GPT-OSS 120B و Deepseek R1 670B و Kimi K2.5 1T، حيث حققت سرعة حوالي 1400 رمز في الثانية على النموذج الأول و 700 رمز على Deepseek R1.
أنجزت Jalapeño هذه النتائج دون الاعتماد على تقنيات متقدمة مثل التنبؤ بعدة رموز أو فك التشفير التخميني، وهي تقنيات استخدمتها بعض أنظمة المقارنة، مما يشير إلى إمكانيات تحسين إضافية. وافقت شركة SemiAnalysis المتخصصة على التحقق من بعض الاختبارات في معاملها، حيث أشاد رئيسها بأداء الرقاقة الأولى الاستثنائية مقابل معالجات Nvidia المتقدمة.
طورت OpenAI الرقاقة بالشراكة مع Broadcom، وبدأ العمل في منتصف عام 2024 وانتقلت إلى مرحلة الإنتاج في نوفمبر 2025. استغرقت الدورة الكاملة نحو 16 شهرًا، بينما احتاجت مراحل التصميم والبرمجة من البداية إلى التصميم النهائي إلى تسعة أشهر فقط. استخدمت OpenAI نماذج الذكاء الاصطناعي الخاصة بها خلال التطوير، حيث ساعدت الإصدارات الأقدم في تصميم الرقاقة والأحدث في تسريع البرمجة والتحسينات.
لم تتجاوز Jalapeño مرحلة العينات الهندسية حتى الآن، بينما أنظمة Vera Rubin من Nvidia تُشحن بالفعل للعملاء. كما أشارت SemiAnalysis إلى أن Nvidia و AMD نشرت نتائج باستخدام نماذج أكبر لم تختبر بعد على Jalapeño.
أكدت نائبة الرئيس المالي بـ OpenAI أن الرقاقة تندرج ضمن استراتيجية حسابية شاملة تدمج مراكز البيانات والرقائق والنماذج والمنصات والمنتجات والأجهزة في نظام متكامل. أضافت أن الرقاقة تكمل الشراكات الحالية مع شركات أخرى بما فيها Nvidia و AWS و AMD بدلًا من تحل محلها.
Comments (0)
No comments yet. Be the first.