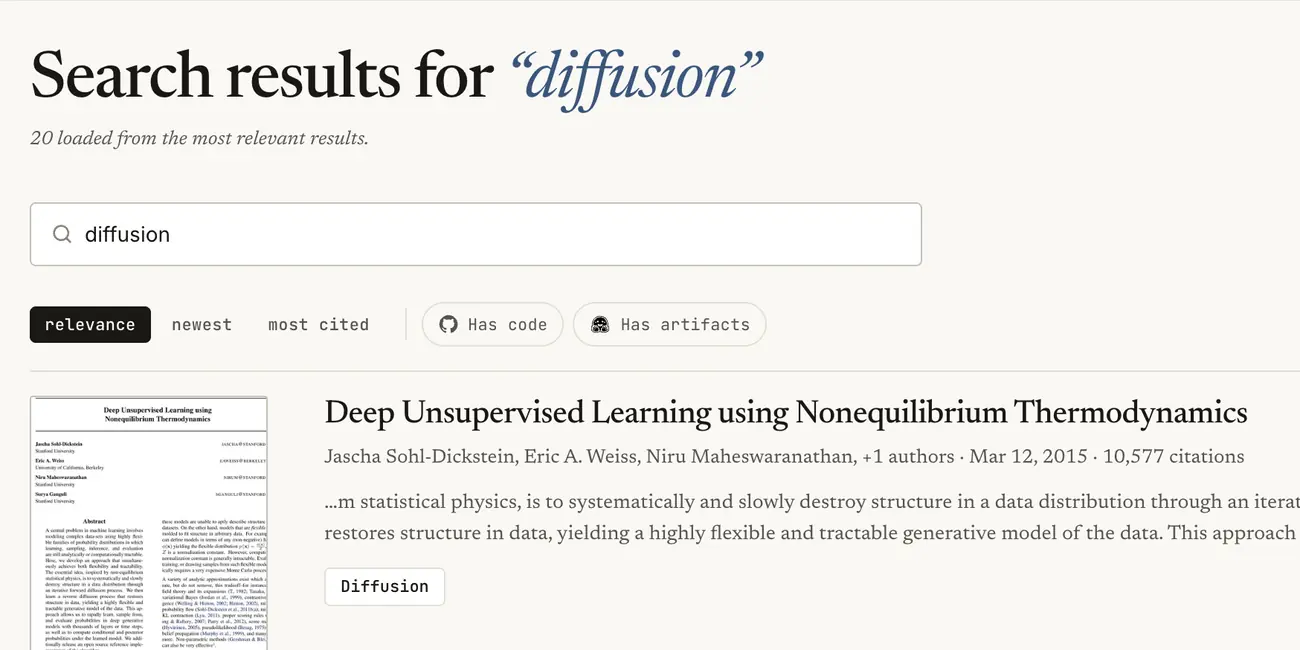
اعتمدت منصة Papers with Code على نظام بحث هجين لجعل الأوراق العلمية أسهل الوصول إليها، حيث يتطلب نظام البحث المتقدم في الأبحاث فهمًا عميقًا للاستعلامات المفاهيمية بجانب القدرة على التعرف على الأسماء والمعرفات الدقيقة، وليس مجرد البحث عن النصوص العادية.
يجمع النظام بين تقنيتي البحث الكلمات المفتاحية والبحث الدلالي باستخدام خوارزمية Reciprocal Rank Fusion. يعتمد جزء البحث الكلماتي على قاعدة بيانات PostgreSQL، بينما يستخدم pgvector لإضافة الفهم الدلالي من خلال تضمينات الكثافة العالية. تدير النظام أكثر من 110 آلاف ورقة بحثية مستمدة من arXiv.
قسمت الفريق المهام بذكاء: تشغيل Jobs قوية من هاجينج فيس لمعالجة ملايين الأوراق بسرعة على معالجات GPU، مع تخزين النتائج في Buckets الآمنة. أثناء البحث الفعلي، يعمل Inference Endpoint واحد فقط يعتمد على نموذج Qwen/Qwen3-Embedding-0.6B المثبت على نسخة محددة بدقة، مما يضمن توافق النسخة والتوثيق الكامل للتضمينات.
حقق نظام البحث في اختباره على 5 آلاف ورقة استدعاء عاليًا بلغ 0.9955 في Recall@20 مع زمن استجابة يترواح بين 1.31 ميلي ثانية و2.21 ميلي ثانية. صممت الفريق العميل على قبول حالات البدء البارد والانقطاع المؤقت للخدمة، حيث ينتقل تلقائيًا إلى البحث الكلماتي عند عدم توفر الخدمة الدلالية.
تتجاهل الحسابات الشاملة للمستودع مشاكل التضمينات الدقيقة بمعاملة صيغة الإدراج كواجهة برمجية موثقة بإصدارات محددة. تتولى عملية تحديث تدريجية كل ساعة إضافة الأوراق الجديدة والمعدلة بحد أقصى 500 ورقة في كل دورة، مما يحافظ على تسامح النظام بين النموذج والقاعدة.



Comments (0)
No comments yet. Be the first.