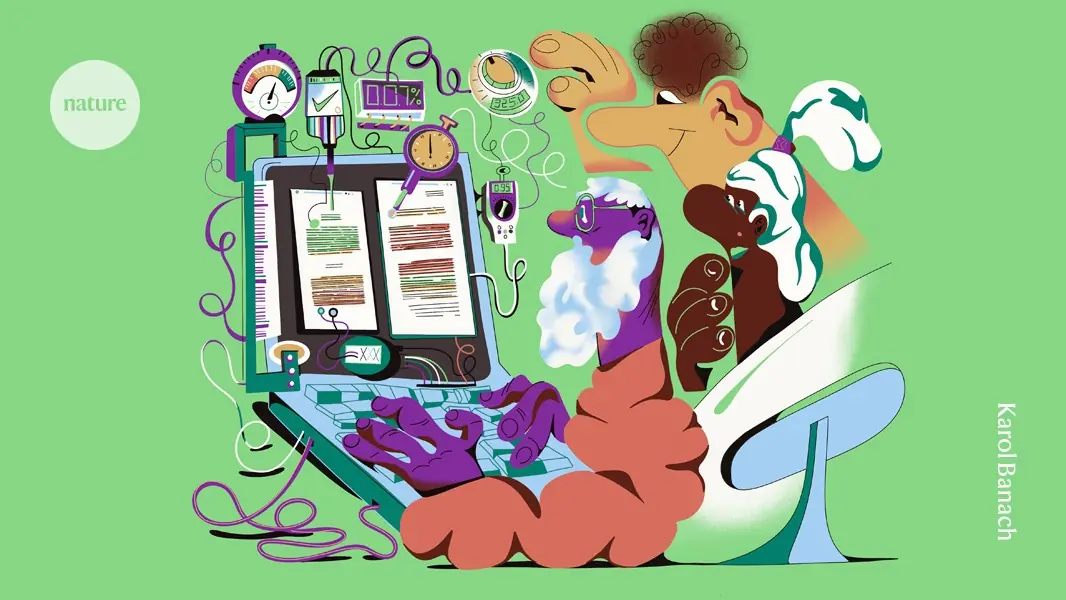
بعد سنوات من الإخفاقات المتكررة، تمكنت شركات متخصصة من تطوير برمجيات قادرة على التمييز بموثوقية بين النصوص المكتوبة بواسطة البشر والنصوص المولّدة بالذكاء الاصطناعي. تُستخدم هذه الأدوات الآن على نطاق واسع في المؤسسات الأكاديمية والناشرين العلميين والمنصات الرقمية الكبرى.
طورت شركتا Pangram و GPTZero نهجاً مختلفاً بالاعتماد على نماذج تعلم آلي متقدمة بدلاً من الطرق الإحصائية القديمة. بدلاً من قياس خصائص مثل التنبؤية وتغيير أطوال الجمل، قامتا بجمع ملايين النصوص البشرية وطلبتا من نماذج اللغة الكبرى إعادة كتابتها، ثم دربتا نماذجهما على التمييز بينهما. أسفرت هذه الطريقة عن نسب أخطاء منخفضة جداً في تصنيف النصوص البشرية كمحتوى مولّد بالذكاء الاصطناعي.
حققت الأداتان نتائج مثيرة للانطباع في الاختبارات المستقلة، حيث لم تسجلا أخطاء في تصنيف آلاف النصوص البشرية. غير أن كفة الدقة جاءت على حساب آخر: قبِلت الأداتان نسبة أخطاء أعلى في اعتبار بعض النصوص المولّدة بالذكاء الاصطناعي كتصوص بشرية، خاصة عندما يُطلب من النماذج محاكاة أسلوب مؤلف معين أو عند التعامل مع نصوص قصيرة جداً.
تواجه الأدوات تحديات إضافية في التعامل مع النصوص المعدّلة أو المهندسة بواسطة متخصصين لإزالة آثار الذكاء الاصطناعي. كما أن فعالية هذه الأدوات تتراجع مع ظهور نماذج لغوية جديدة، ما يضطر الشركات لتحديث برمجياتها باستمرار. طورت GPTZero 23 تحديثاً لنماذجها خلال السنة الماضية وحدها.
على الرغم من التقدم الملحوظ، يؤكد الخبراء أن هذه الأدوات يجب أن تكون نقطة انطلاق للتحقيق فحسب وليس دليلاً نهائياً. كما أن دقة الأرقام المعلنة من الشركات نفسها لم تخضع للتحقق الخارجي، وهذا ما يجعل الاختبارات المستقلة متأخرة دائماً عن آخر إصدارات هذه الأدوات.
Comments (0)
No comments yet. Be the first.