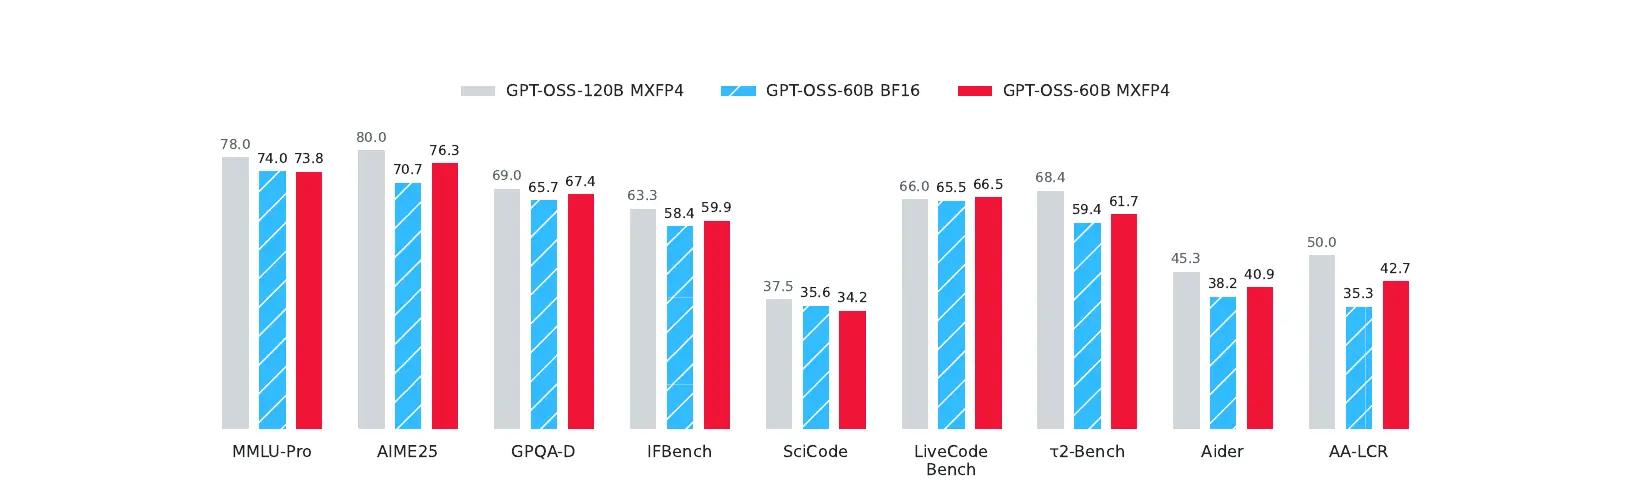
نشرت شركة Multiverse Computing بحثًا يعالج مشكلة طويلة الأمد في مجال ضغط نماذج الذكاء الاصطناعي: كيفية استعادة الأداء بعد خضوع النموذج للضغط الهيكلي والتكميم معًا. وقدمت التقنية الجديدة المسماة "الشفاء الواعي للتكميم" (QAH)، التي تطبقها على نموذج GPT-OSS بـ 120 مليار معامل مضغوط إلى 60 مليارًا وكمّم إلى دقة MXFP4. النتيجة نموذج يتفوق على نسخته الأصلية بدقة 16 بت في 7 من أصل 9 اختبارات قياسية.
تختلف تقنية QAH عن الطرق التقليدية التي تعتمد على التدريب الواعي للتكميم (QAT)، وهي عملية مكلفة تعيد تشغيل عملية ما بعد التدريب بأكملها على دقة منخفضة. بدلًا من ذلك، تقوم QAH بتحويل المعرفة مباشرة من النموذج الأصلي كاملًا إلى النسخة المكممة، باستخدام تباعد Kullback-Leibler على مخرجات النموذج. هذا المنهج يتجاوز قيود الطرق السابقة التي كانت تحتاج لنموذج معلم من نفس الهندسة المعمارية للنموذج المضغوط.
أظهرت الاختبارات أن نموذج QAH بـ 4 بت يصل إلى أداء ذروة تبلغ 54.9 في حوالي 100 خطوة تدريب، ويحافظ على هذا الأداء طوال التدريب، بينما QAT يحتاج إلى 700 خطوة للوصول إلى 54.6 ثم ينخفض بحدة بعدها. هذا يعني أن نماذج QAH أكثر استقرارًا وأقل عرضة للانهيار في الأداء.
من حيث الكفاءة، يستخدم نموذج QAH المضغوط ذاكرة أقل بحوالي 4 مرات من نسخة 16 بت، وبمعاملات أقل بالنصف من المعلم الأصلي، يقلل الحساب المطلوب لكل رمز بحوالي النصف. هذا يسمح بتشغيل النموذج على عتاد أصغر بكثير وتكلفة تشغيل أقل.
على اختبارات معينة، تفوق النموذج بفارق ملحوظ: حصل على 7.4 نقطة إضافية في اختبار الاستدلال طويل السياق و5.6 نقاط في اختبارات الرياضيات، وهي المجالات التي يضر فيها الضغط عادة. النموذج المضغوط تفوق أيضًا على النموذج الأصلي كاملًا في اختبار LiveCodeBench رغم استخدام ربع الذاكرة تقريبًا.



Comments (0)
No comments yet. Be the first.