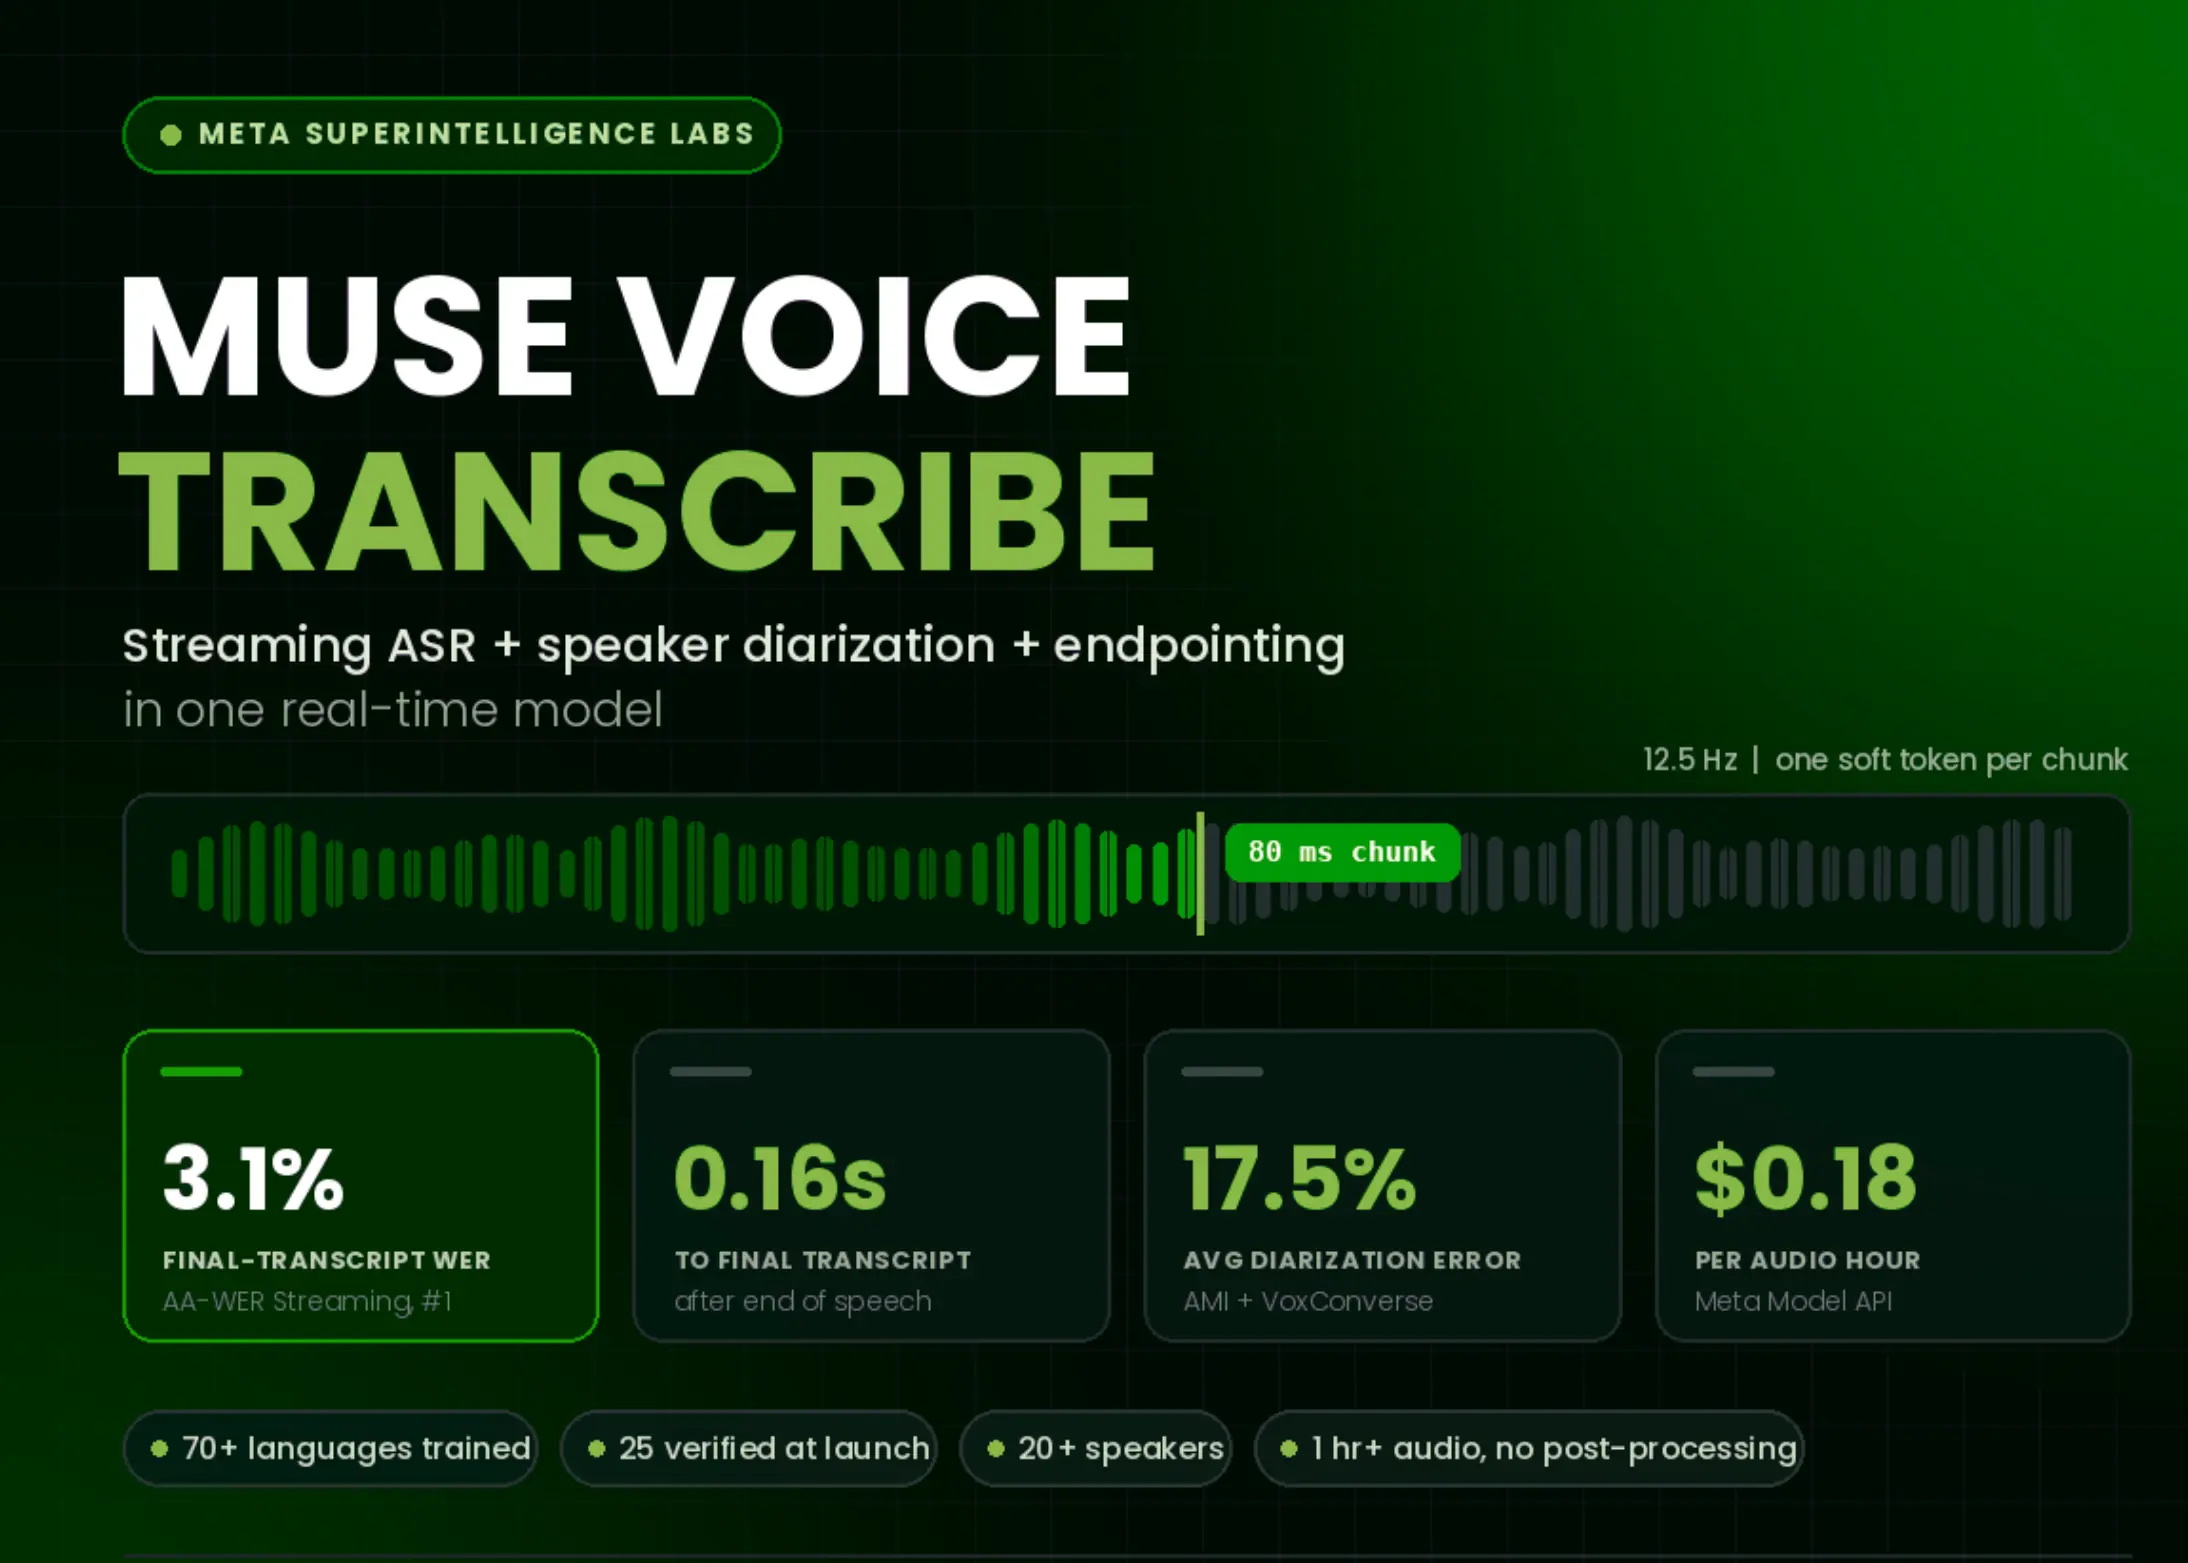
أطلقت مختبرات ميتا للذكاء الخارق نموذج صوتي جديد يسمى Muse Voice Transcribe، يدمج ثلاث وظائف منفصلة تقليديًا في نظام واحد. النماذج الحالية في الإنتاج تتطلب عادة ثلاثة أنظمة متتالية: أحدها للنسخ، وآخر لفصل المتحدثين، وثالث لكشف انتهاء الحديث. يزيل النموذج الجديد هذه التعقيدات بدمجها في نموذج واحد انحداري يعالج البيانات الصوتية دفعة واحدة.
النموذج متاح حاليًا عبر واجهة برمجية تابعة لميتا بسعر ثلاثة دولارات لكل ألف دقيقة صوتية، أي ثمانية عشر سنتًا للساعة الواحدة. يدعم النموذج أكثر من عشرين لغة موثقة بشكل شامل، مع قدرة أصلية على التعامل مع الكود المختلط حيث يمزج المتحدثون لغات متعددة ضمن الجملة الواحدة. لا توجد نسخة ذاتية الاستضافة متاحة حتى الآن، إذ لم تُطلق ميتا أوزان النموذج للعموم.
يعتمد النموذج على بنية معمارية تستقبل مقاطع صوتية مدتها ثمانون ميلي ثانية بمعدل 12.5 هرتز. بعد معالجة كل مقطع، يقرر النموذج ما إذا كان يستمع لمزيد من الكلام أو يبدأ في إخراج نصوص. تطبق ميتا تعلمًا معززًا يجمع بين مكافآت معدل الخطأ الكلمي وتأخير الاستجابة، ما ينتج سياسة تتكيف مع صعوبة كل كلمة بدلاً من إصلاح المقايضة بين السرعة والدقة.
تفوق النموذج على المنافسين وفق معايير قياسية متعددة. حقق معدل خطأ نهائي بنسبة 3.1 في المئة مع تأخير 0.16 ثانية، متفوقًا على Cartesia Ink-2 بـ 3.4 في المئة و0.43 ثانية، و ElevenLabs Scribe v2 بـ 3.6 في المئة. في مهمة التعرف على المتحدثين، سجل النموذج معدل خطأ 17.5 في المئة، بينما تراوح أداء الأنظمة الأخرى بين 21.1 و28.6 في المئة. السعر أيضًا أقل من نظرائه: Cartesia بأربعة دولارات والمنافسون الآخرون بستة دولارات فما فوق.
النموذج يدعم ملفات صوتية تتجاوز ساعة وعشرين دقيقة مع أكثر من عشرين متحدثًا دون الحاجة لمعالجة لاحقة. يعمل حاليًا على تشغيل ميزة الإملاء في Meta AI لأنظمة ماك، ويستخدم في Muse Code أيضًا.



Comments (0)
No comments yet. Be the first.