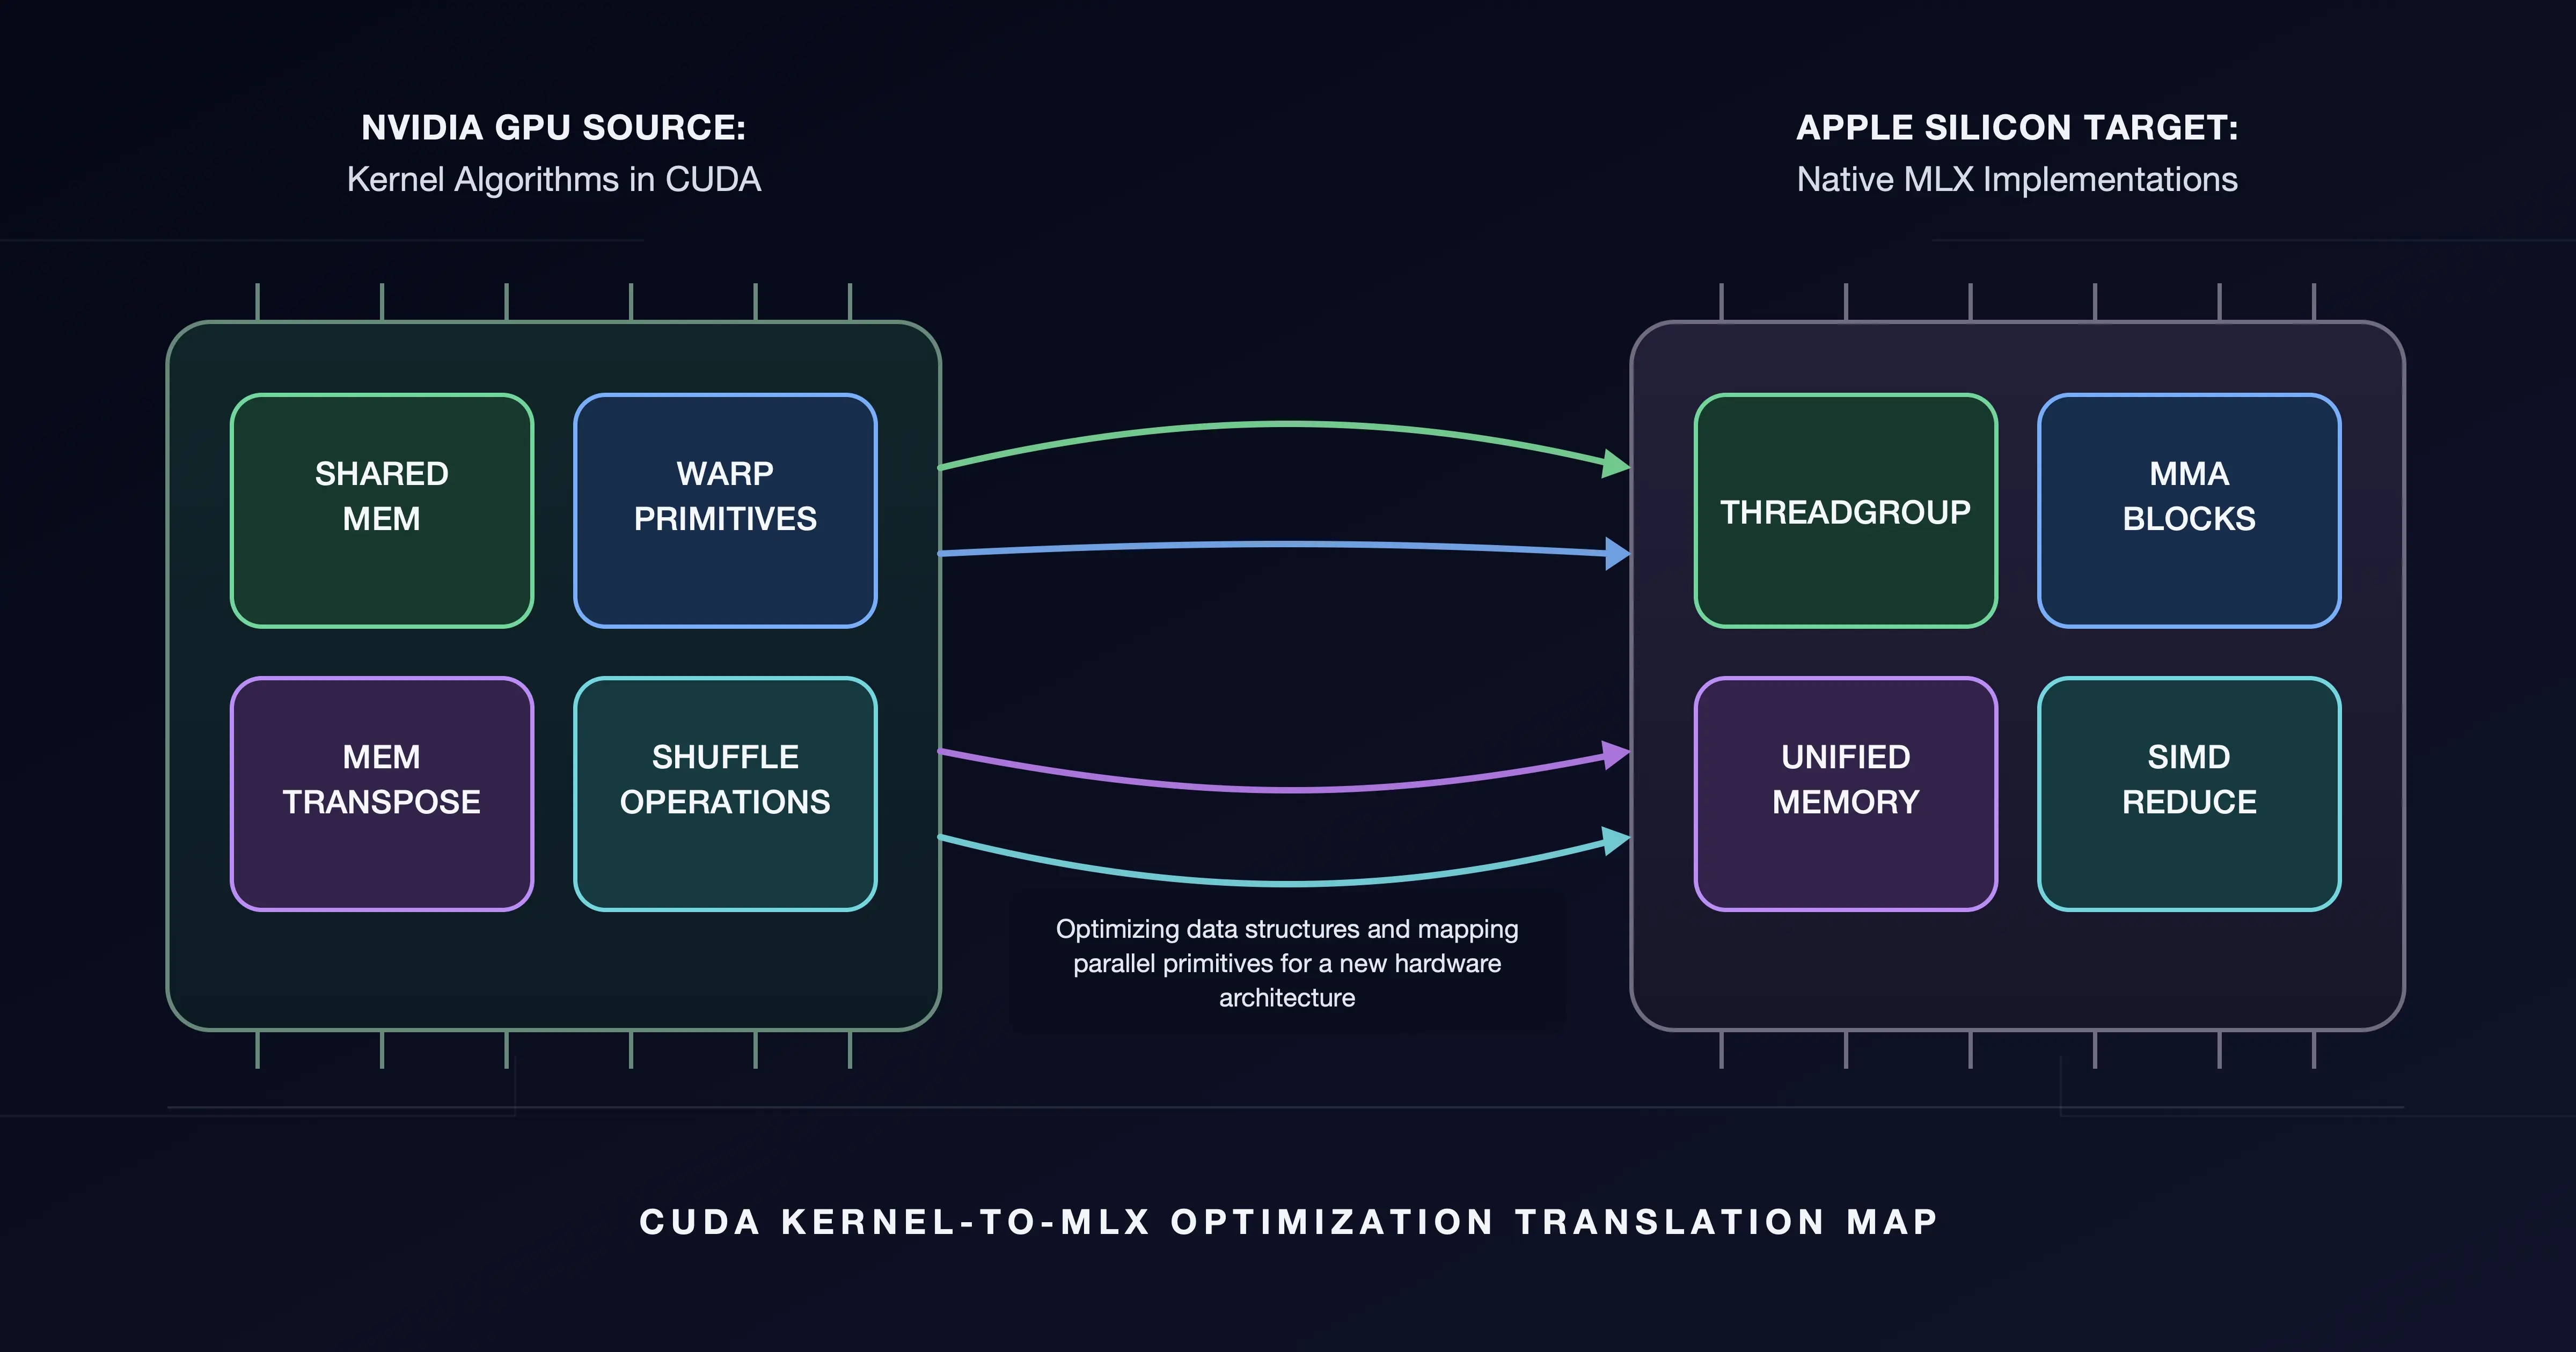
طوّر فريق بحثي من جامعة بيركلي نسخة محسّنة من إطار العمل K-Search، وهي أداة تستخدم الذكاء الاصطناعي لتحسين أداء نوى المعالجات. المشروع يركز على نقل المعرفة المتراكمة من نوى CUDA إلى معالجات Apple Silicon، مما يوفر على المهندسين الاضطرار إلى إعادة اكتشاف التحسينات من الصفر.
تكمن المشكلة في أن نظام CUDA من إنفيديا جمّع عبر السنوات خبرات هندسية ضخمة تجسّدت في نوى محسّنة يدويًا لعمليات حرجة مثل الانتباه ونماذج الفضاء الحالة. أما أنظمة العتاد الجديدة كمعالجات أبل المخصصة للذكاء الاصطناعي فتفتقر لهذا العمق التقني، مما يترك أداة ضخمة على الطاولة.
الحل يتمثل في طبقة ترجمة هندسية من CUDA إلى MLX تسمح لـ K-Search بأخذ نوى CUDA الموجودة كقاعدة معرفة وتكييفها لمعالجات Apple Silicon بدلًا من البناء من الصفر. الأداة تستخدم نموذج لغة لتحليل الأداء ونموذجًا آخر لتوليد نوى محسّنة، ثم تختبرها على العتاد الحقيقي.
أظهرت النتائج أن النهج يحقق أداءً قريبًا من مستوى الخبير في معالجات Apple Silicon بمعدل 0.97x بالمقارنة مع نواة الانتباه الأصلية في MLX، وتسريعًا يصل إلى 20 مرة في عمليات ملء السياق لنواة Mamba. طبقة الترجمة وحدها مسؤولة عن قفزة من 0.26x إلى 0.97x في الأداء.
الطريقة ليست حصرية على MLX وقابلة للتطبيق على أي نظام يمكن نقل خبرات CUDA إليه. أبل شهدت اعتمادًا متسارعًا على إطار عمل MLX منذ أواخر 2023، حيث تعمل المعالجات في مئات الملايين من أجهزة MacBook و Mac Studio، مما يتيح الاستدلال المحلي للنماذج الذكية دون تكاليف الحوسبة السحابية.
Comments (0)
No comments yet. Be the first.