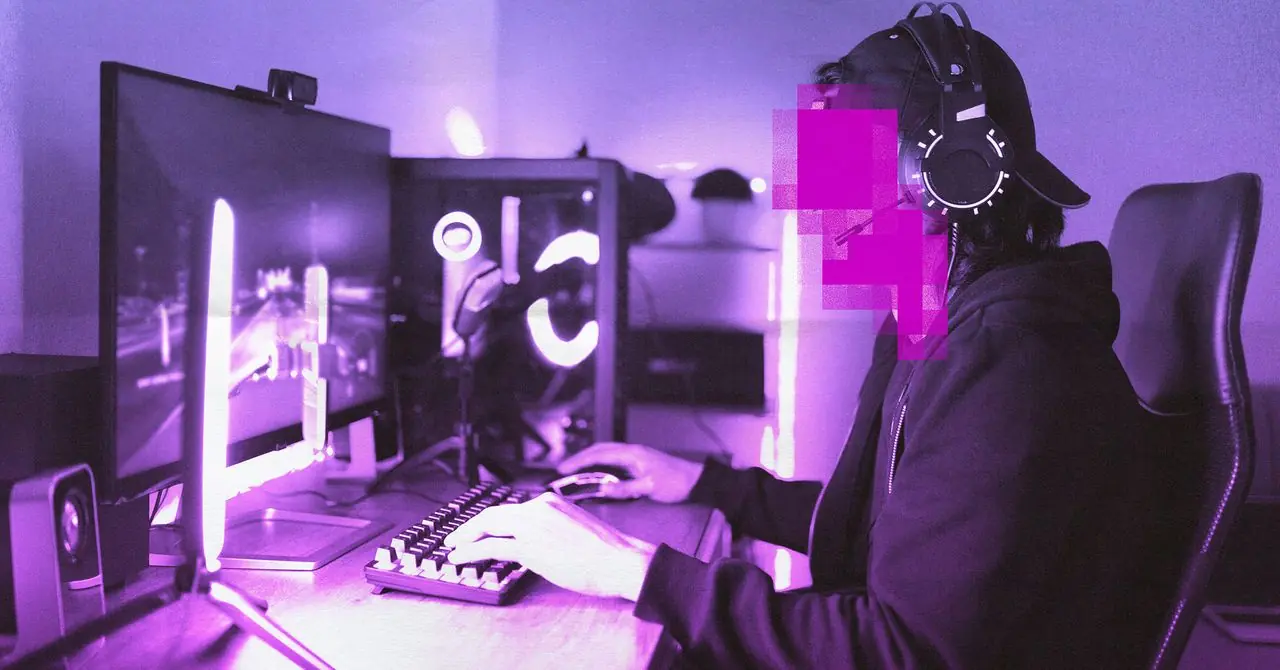
أعلنت منصة البث Twitch عن تحديث إعدادات الحسابات يتيح للمذيعين رفض استخدام محتوياتهم في تدريب نماذج الذكاء الاصطناعي التابعة لشركة الأم أمازون. وتتم عملية الامتناع بخطوات بسيطة عبر الموقع أو التطبيق المحمول، من خلال الدخول إلى الإعدادات ثم قسم الأمان والخصوصية، حيث يوجد خيار تعطيل استخدام المحتوى لأغراض التدريب الذكي.
إلا أن الكشف عن هذه الممارسة أثار قلقًا واسعًا بين منشئي المحتوى. فقد عبّر أكثر من 16 ألف منشئ عن معارضتهم لاستخدام محتوياتهم بشكل افتراضي في تدريب أنظمة أمازون الذكية، وهي ممارسة لم تُكشف عنها سوى بعد التحديث الأخير. أقرّت ماري كيش، رئيسة قسم المجتمع في Twitch، بأن التغيير سيثير ردود فعل سلبية، فيما أوضح مايك مينتون، رئيس المنتجات، أن إبقاء الخيار مفعلًا افتراضيًا كان ضروريًا وإلا "لن يشارك أحد" في العملية.
أثار الكشف عدة استفسارات جوهرية: منذ متى تستخدم Twitch محتويات منصتها في تدريب النماذج الذكية؟ هل أمازون هي الشركة الوحيدة التي تفعل ذلك؟ إلى أي حد يتم احترام حقوق الملكية للمحتوى الذي ينشره المنشئون؟ وفقًا للشروط المحدثة في مارس 2024، منحت Twitch نفسها والجهات المرخصة الحق في استخدام المحتوى وتعديله وتوزيعه وإنشاء أعمال مشتقة منه، لكن لم تذكر صراحة استخدامه في تدريب نماذج الذكاء الاصطناعي التوليدي.
تعكس الحالة تحديًا حقيقيًا يواجه مطورو أنظمة الذكاء الاصطناعي: نقص البيانات عالية الجودة. فبينما توصلت شركات مثل OpenAI إلى اتفاقيات مع ناشرين مختلفين لاستخدام محتوياتهم، تتناقص مصادر البيانات المتاحة مع تطور التكنولوجيا وارتفاع الطلب. لهذا بدأت Meta وGoogle واليوتيوب باستخراج محتويات المستخدمين لذات الغرض، مما أعاد فتح نقاش أخلاقي حول شفافية عمليات التدريب.
أصبحت البيانات التدريبية عالية الجودة مورداً استراتيجياً حاسماً لمطوري الذكاء الاصطناعي، مثلما هو الحال مع الرقائق والطاقة الكهربائية. ويشير كل المؤشرات إلى أن جزءًا كبيرًا من هذا الطلب يُغطى بمعلومات ينتجها المستخدمون أنفسهم في مقابل الحصول على خدمات رقمية مجانية.

Comments (0)
No comments yet. Be the first.