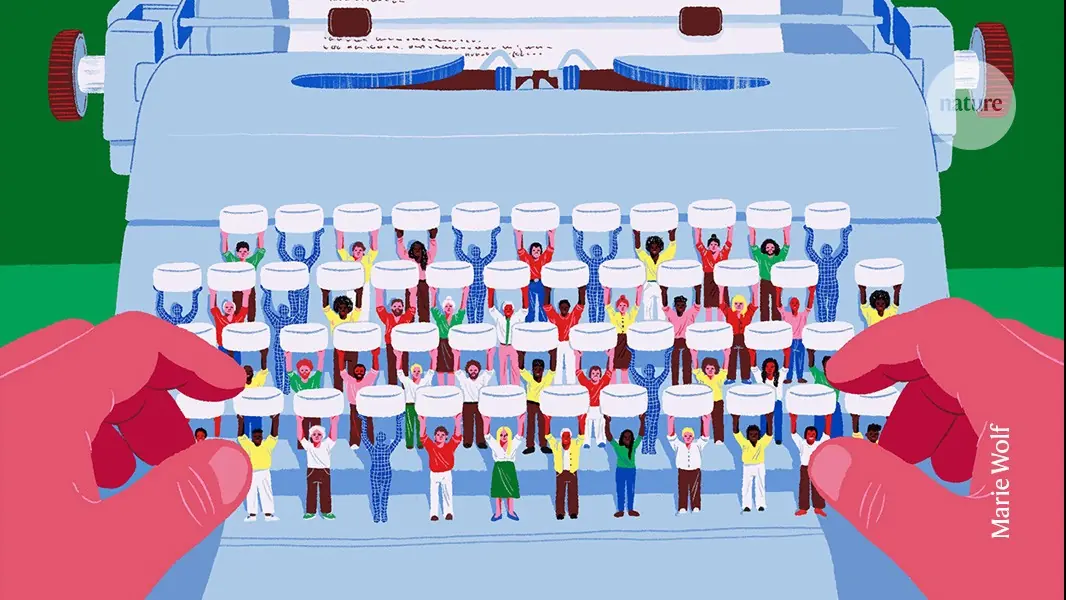
أثارت الاستخدامات المتزايدة لأدوات الذكاء الاصطناعي التوليدية في البحث العلمي تساؤلات جوهرية حول المسؤولية الفكرية والأخلاقية. تستخدم هذه الأدوات اليوم في تلخيص الدراسات وإنتاج الأفكار والرد على ملاحظات المراجعين وتحسين النصوص، مما يطرح سؤالًا محرجًا: ماذا يعني أن يكون الباحث مؤلفًا حقيقيًا عندما يعتمد على وساطة تقنية؟
التأليف في العلوم ليس حقًا بل إنجاز مكتسب يعترف به المجتمع العلمي بدلالة على كفاءة الباحث ومسؤوليته. لكن الذكاء الاصطناعي يختلف جوهريًا عن المساهمين البشريين؛ فمساعد الدراسات يستطيع تبرير عمله والاعتراف بالخطأ والتعلم من النقد، بينما لا تملك أنظمة الذكاء الاصطناعي هذه الصفات، وبالتالي لا يمكن مساءلتها على الدقة والموثوقية.
تنقصنا حاليًا فئات واضحة لتصنيف العمل الموسوط بالذكاء الاصطناعي ضمن أنظمة النسب الحالية مثل CRediT. بينما كانت هذه الأنظمة مناسبة للعمل البشري، فإنها عجزت عن تتبع دور الذكاء الاصطناعي بدقة، الأمر الذي يجعل من المستحيل معرفة من فعل ماذا وكيفية توزيع الفضل والمسؤولية.
تتجاوز مشكلة النسب الأكاديمي فريق الكتابة إلى البنية الكاملة للنشر العلمي. بدأ الذكاء الاصطناعي يؤثر على اختيار المراجعين وصياغة القرارات التحريرية وجودة التقييمات، وهي عمليات تشكل مستقبل البحث ومصداقية الباحثين.
النقاش الحالي يجب أن يتسع ليشمل المسائل الهيكلية الأعمق. دخول الذكاء الاصطناعي إلى الحياة الأكاديمية يفتح الفرصة لإعادة النظر في هرميات الاعتراف بالعمل العلمي برمتها، لا مجرد إضافة أداة جديدة. فإذا استحقت العمليات الموسوطة بالذكاء الاصطناعي الاعتراف بالتأليف، فلماذا لا ينطبق الشيء ذاته على مساعدي الدراسات البشريين الذين يؤدون العمل ذاته؟

Comments (0)
No comments yet. Be the first.