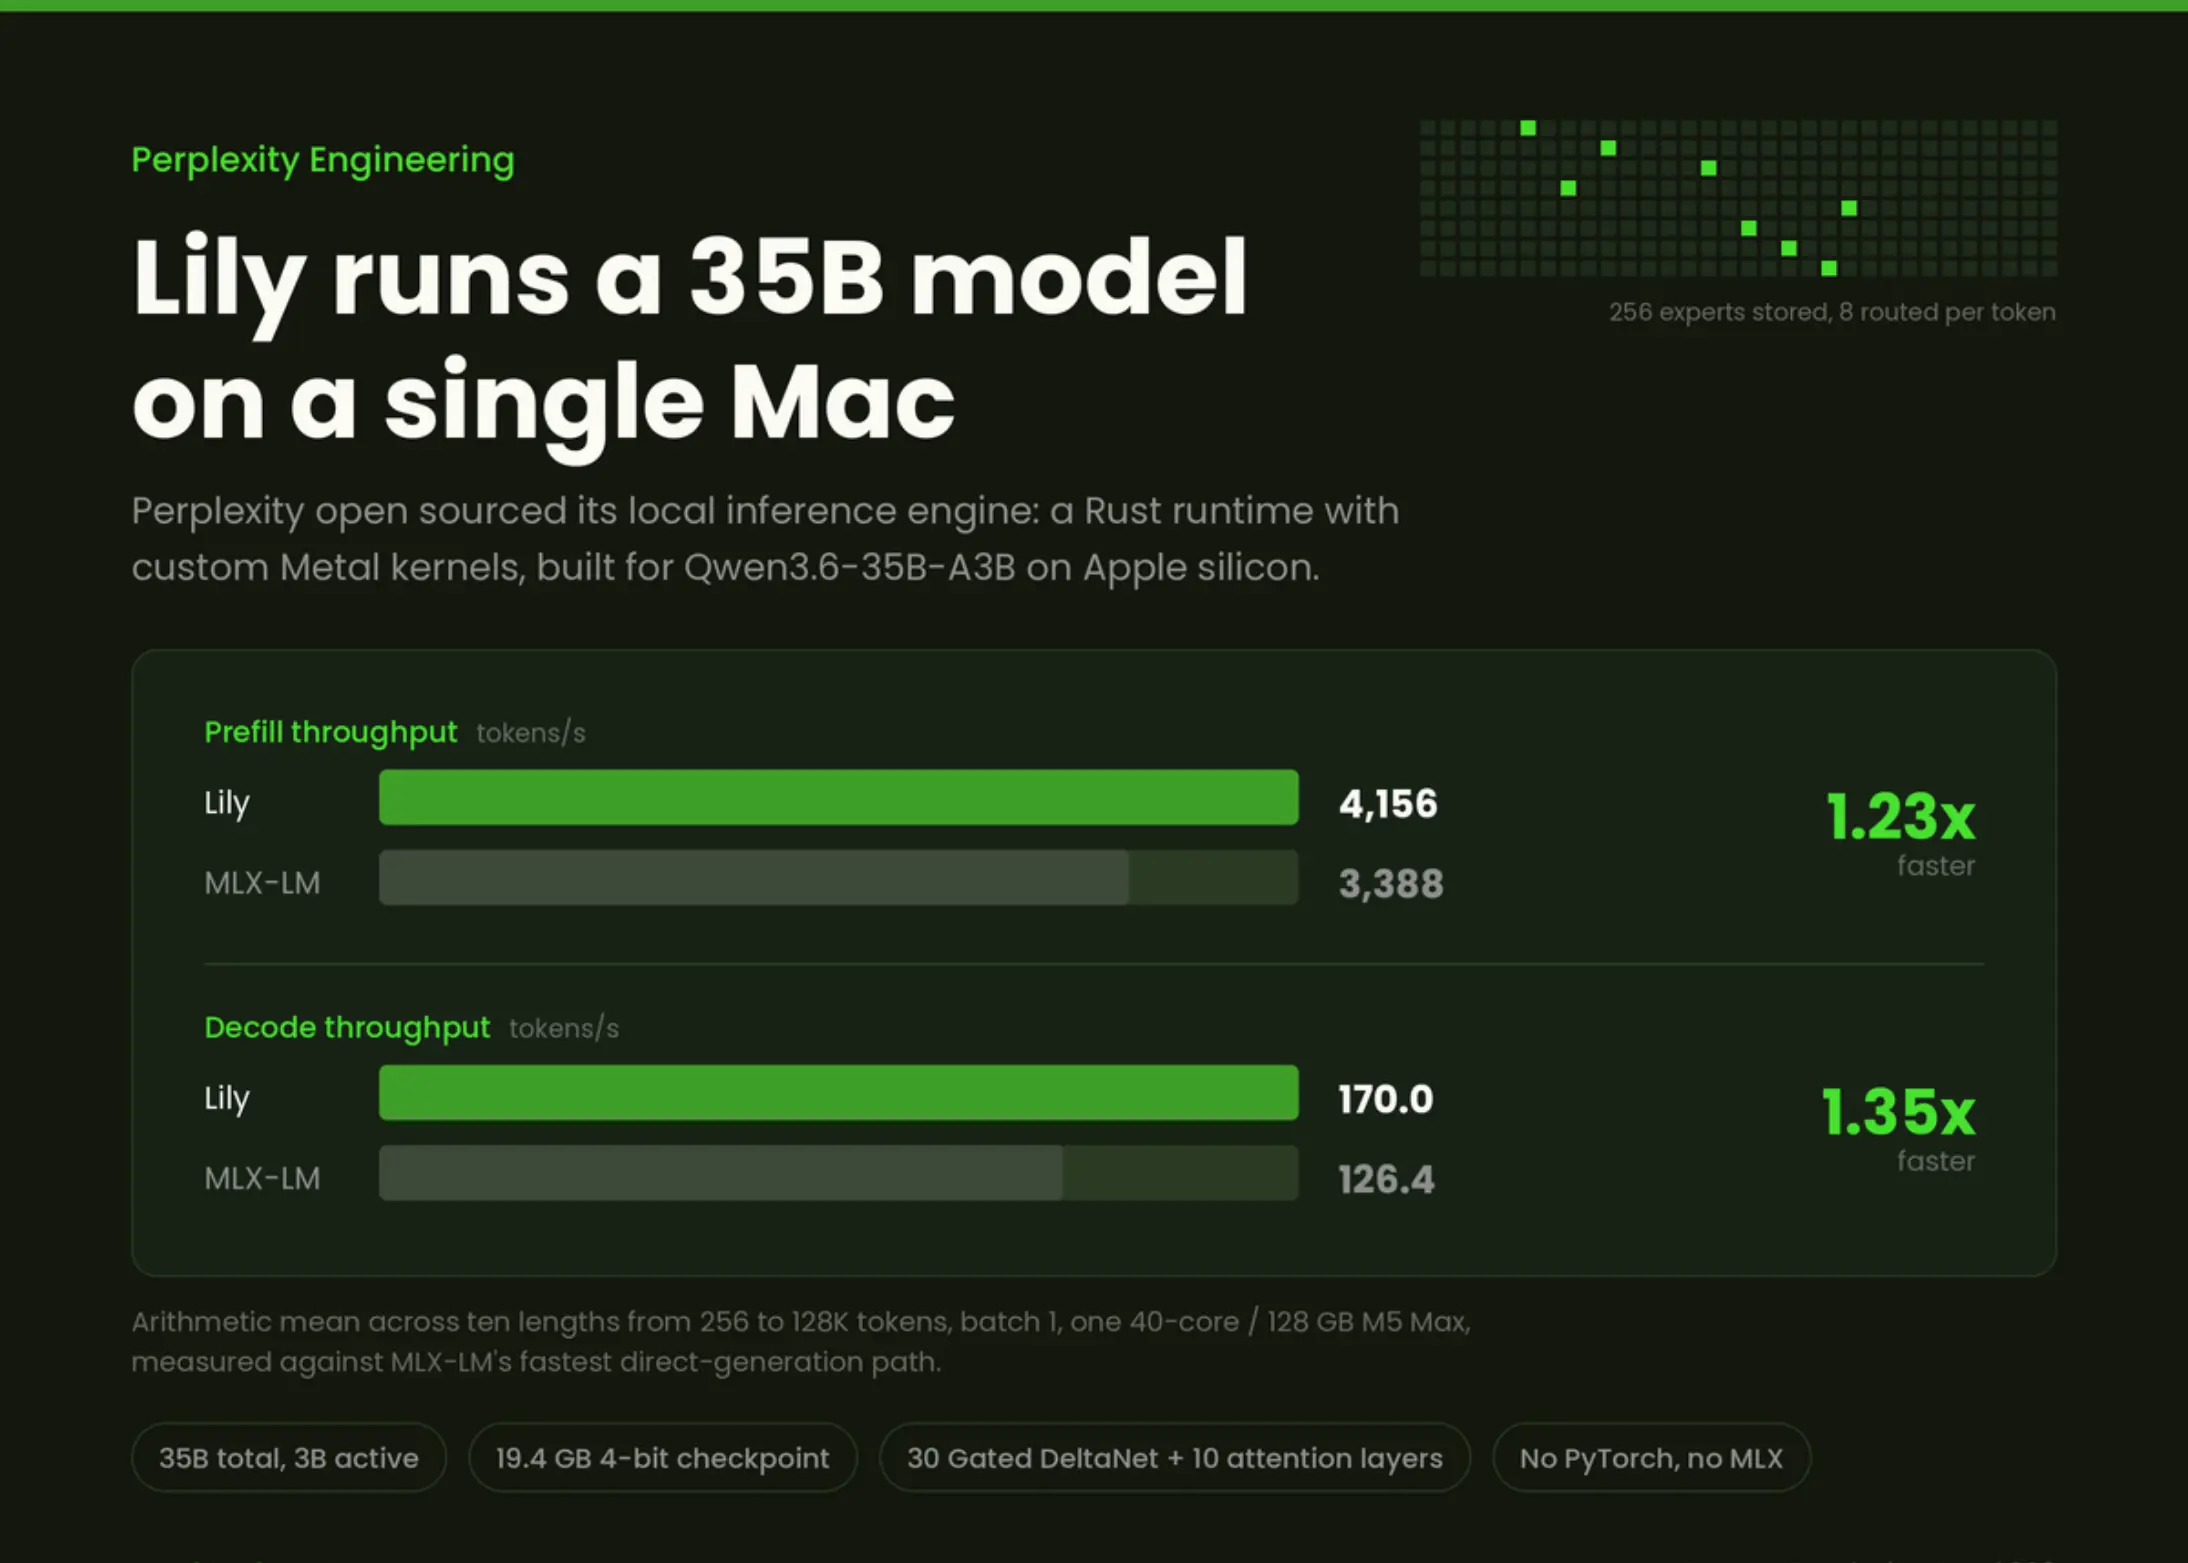
أعلنت شركة Perplexity عن إطلاق Lily، محرك استدلال محلي متخصص يقوم بتشغيل نموذج Qwen3.6-35B-A3B على معالجات آبل السيليكون. يجمع المحرك بين طبقة Rust وتطبيقات Metal المكتوبة يدويًا، مما يلغي الحاجة إلى PyTorch أو MLX في مسار التنفيذ، وبذلك يركز على الأداء المثلى من خلال التخصص الضيق.
يتطلب التشغيل الفعلي لـ Lily جهاز Mac بمعالج آبل سيليكون وذاكرة موحدة لا تقل عن 32 غيغابايت، حيث أن نقطة التفتيش بدقة 4 بت تبلغ حجمها 19.4 غيغابايت. أتاحت Perplexity نسخة توضيحية مستقلة في مستودع pplx-garden، وهي خادم استدلال يقدم خدمة توليد النصوص عبر واجهة برمجية موافقة لـ OpenAI.
يتميز نموذج Qwen3.6-35B-A3B بمعمارية معقدة تجمع بين 256 خبيرًا (يتم تفعيل 8 منها لكل رمز مع خبير مشترك واحد)، و10 طبقات انتباه كامل، و30 طبقة Gated DeltaNet. قام فريق Perplexity بعدة تحسينات تقنية منها دمج فك الضغط الكمي مع عمليات GEMM المجمعة، وهو ما حقق تحسنًا بنسبة 77.4 بالمئة في سرعة معالجة المدخلات بطول 512 رمز.
أظهرت الاختبارات أن Lily يتفوق على MLX-LM في الأداء بشكل ملحوظ. عند معالجة رموز المدخلات حقق تحسنًا بنسبة 1.23 مرة، بينما وصل التحسن في فك التشفير إلى 1.35 مرة. عند مستويات سياق أعلى (32 ألف إلى 128 ألف رمز)، وصلت التحسينات إلى 40.2 بالمئة في بعض الحالات، مع الحفاظ على دقة الاستدلال حيث بلغت نسبة تطابق الرموز الأعلى ترتيبًا 96.35 بالمئة.
تم نشر الكود بالكامل على منصة GitHub، مما يتيح للمطورين الوصول إلى محرك الاستدلال المتخصص هذا وتعديله حسب احتياجاتهم. يمثل Lily نهجًا مختلفًا عن الحلول العامة بالتركيز على التخصص والأداء المثلى بدلاً من المرونة الموسعة.



Comments (0)
No comments yet. Be the first.