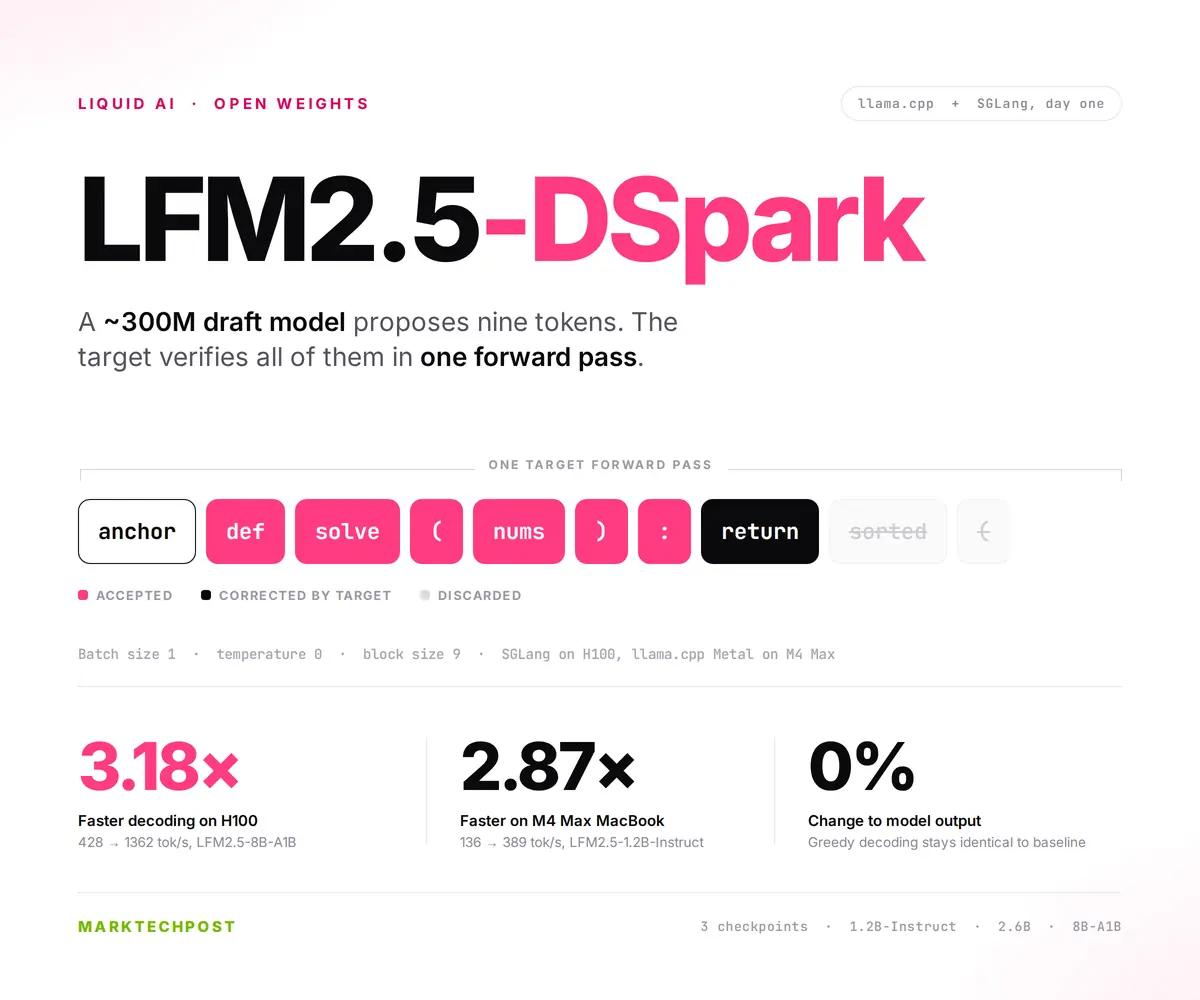
أعلنت شركة Liquid AI عن إطلاق نقاط تفتيش نماذج DSpark مساعدة لثلاثة نماذج من عائلتها LFM2.5، وهي LFM2.5-1.2B-Instruct و LFM2.5-2.6B و LFM2.5-8B-A1B. يعتمد كل نموذج مساعد على تقنية فك تشفير تخميني تقترح كتلة من تسعة رموز مرشحة، ثم يتحقق النموذج الأساسي من الكتلة بأكملها في خطوة واحدة فقط.
تحقق النماذج المساعدة مكاسب أداء ملحوظة مقابل استهلاك ذاكرة إضافي محدود. بلغ التسريع 3.18 مرة على معالج H100 و2.87 مرة على حاسوب MacBook Pro M4 Max، بينما تبقى مخرجات النموذج محفوظة تمامًا دون أي تغيير. يتطابق التسلسل المُنتج حرفيًا مع ما ينتجه النموذج الأساسي وحده، مما يضمن عدم تأثر دقة المعايير.
تعتمد تقنية DSpark على ثلاث مكونات أساسية. يولد عمود فقري موازٍ بأسلوب DFlash حالات مخفية لجميع الرموز المساعدة في خطوة واحدة، ثم يستعيد رأس تسلسلي خفيف الوزن التبعيات بين الرموز المجاورة بناءً على نموذج ماركوف. يتنبأ المدقق الموازن للثقة باحتمالية بقاء كل رموز ويزيل البادئات منخفضة الثقة عندما تكون التحقق مكلفة.
أثبتت الاختبارات أن معدل التسريع يرتبط ارتباطًا مباشرًا بمعدل قبول الرموز، والذي بدوره يعتمد على توقعية المخرجات. حققت LFM2.5-8B-A1B قبول 8.27 من كل 10 رموز على مجموعة MATH500، بينما انخفض إلى 4.02 على GSM8K، ما أدى إلى تفاوت التسريع من 3.18 مرة إلى 1.29 مرة على نفس المعالج.
وجدت الشركة أن أكبر الفوائد تتحقق في سيناريوهات استدعاء الأدوات المتعددة، حيث خفضت التقنية زمن الاستجابة بنسبة 57 في المائة للنموذج LFM2.5-2.6B. أما على معالجات Apple، فكان الأداء أقل وضوحًا، بتسريع بلغ 1.18 مرة فقط على M4 Max، معزوة إلى تطبيق معمارية الخبراء المتعددة الحالية في الواجهة الخلفية Metal للمكتبة llama.cpp. تتوفر أوزان النماذج بصيغ Safetensors و GGUF، مع دعم فوري من أدوات SGLang و llama.cpp.
Comments (0)
No comments yet. Be the first.