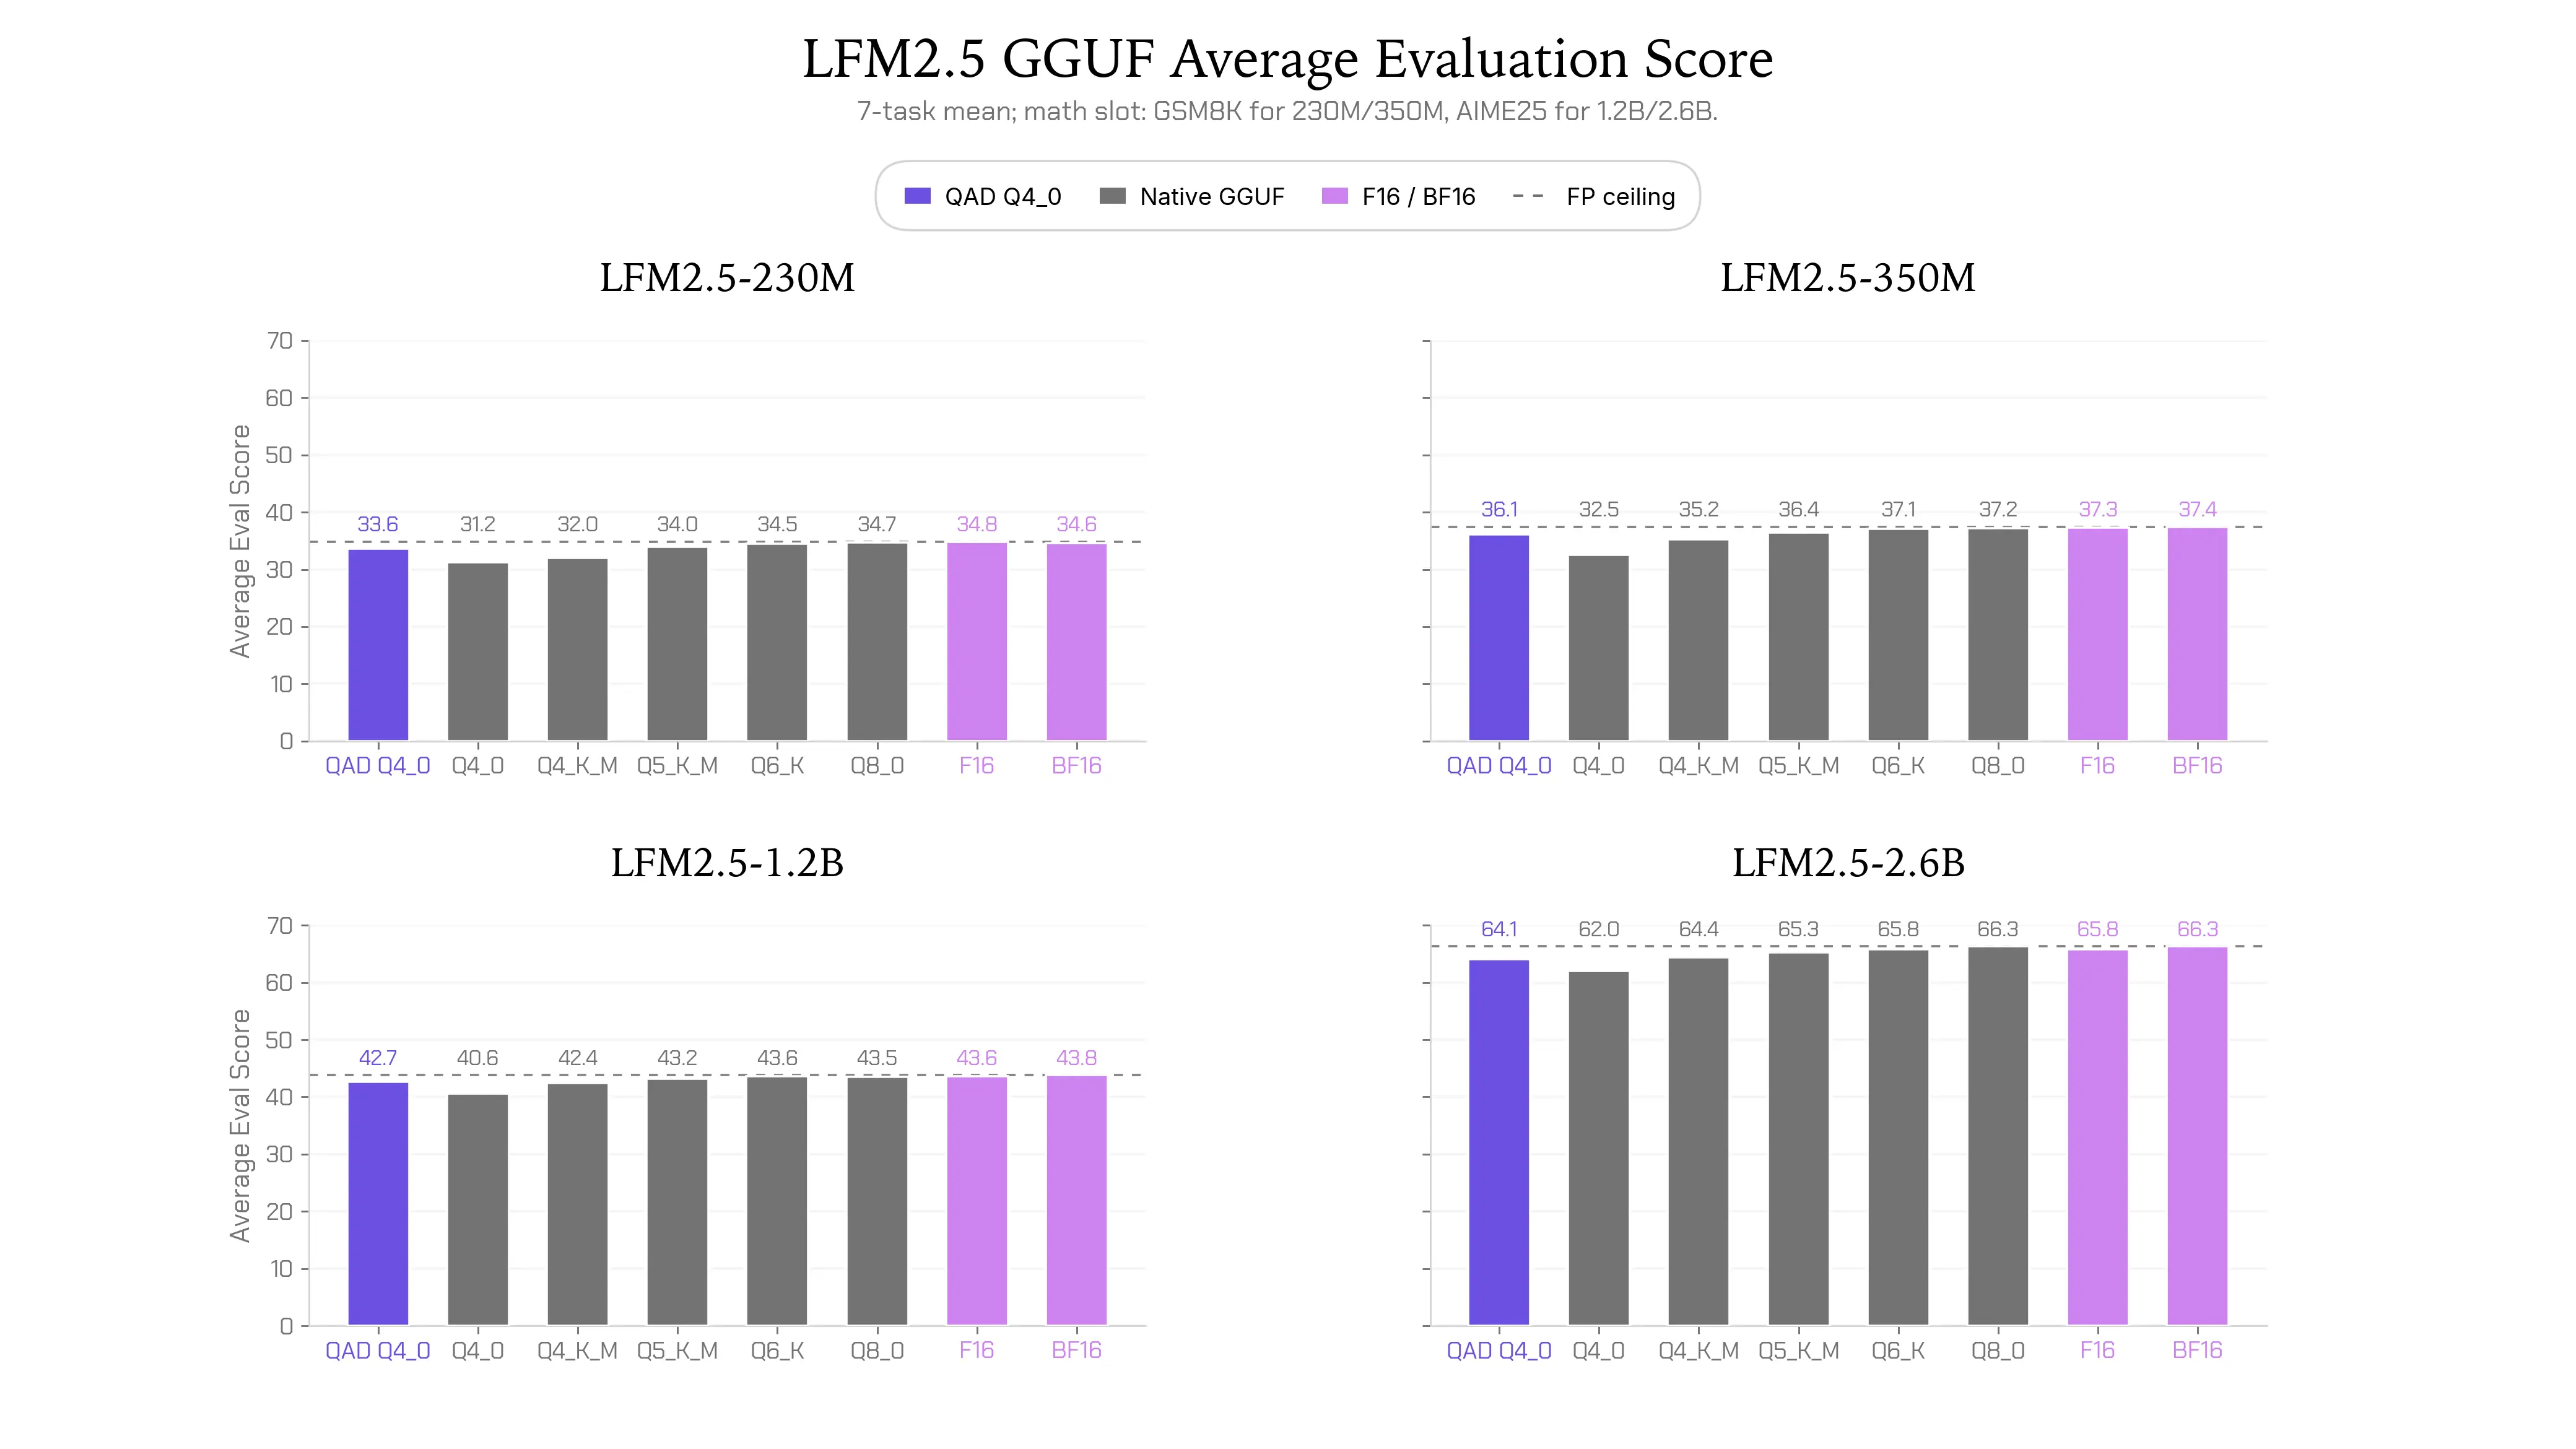
أعلنت شركة Liquid AI عن توفر نماذجها اللغوية LFM2.5 بإصدارات مكممة باستخدام تقنية التكميم الواعي القائم على التقطير، ما يمكّن من تشغيل هذه النماذج على أجهزة محدودة الموارد دون فقدان ملموس في الأداء.
اختبرت الشركة أربعة إصدارات من نماذجها على مجموعة شاملة من معايير التقييم تغطي الاستدلال والاتباع التعليمات والتدخل الأداتي والقدرات الموكلة، وهي GPQA Diamond وMMLU-Pro وIFEval وIFBench وMulti-IF وBFCLv4، إضافة إلى تقييمات حسابية متناسبة مع حجم كل نموذج. أظهرت النتائج أن نماذج التكميم الواعي احتفظت بـ97.1% و96.5% و97.4% و96.6% من أداء النماذج الأصلية بصيغة BF16 على التوالي.
على صعيد الأداء العملي، حققت النماذج الأصغر حجماً (230M و350M) جودة مماثلة لنماذج Q5_K_M مع تحسن في سرعة المعالجة يتراوح بين 4% و33%، بينما حققت النماذج الأكبر (1.2B و2.6B) مستويات جودة مشابهة لـ Q4_K_M مع تحسن يتراوح بين 3% و14% في السرعة. اختبرت الشركة الأداء على أجهزة متعددة تشمل MacBook Pro و NucBox EVO-X2 و Samsung Galaxy S26 Ultra و Raspberry Pi 5.
تدعم النماذج المكممة تطبيق llama.cpp وأي بيئة تشغيل توافقية مع صيغة GGUF Q4_0، وهي متاحة الآن على منصة Hugging Face بأربعة إصدارات: LFM2.5-230M و LFM2.5-350M و LFM2.5-1.2B-Instruct و LFM2.5-2.6B.



Comments (0)
No comments yet. Be the first.