أعلنت منصة Hugging Face عن إطلاق BenchMIRT، وهي أداة جديدة تُعاد صياغة طريقة فحص اختبارات نماذج اللغة الكبرى. تعمل الأداة على مستوى كل سؤال أو مهمة على حدة بدلاً من النظر للنتيجة الإجمالية، مما يساعد في التعرف على القدرات الفعلية التي يقيسها الاختبار بحقيقة الحال.
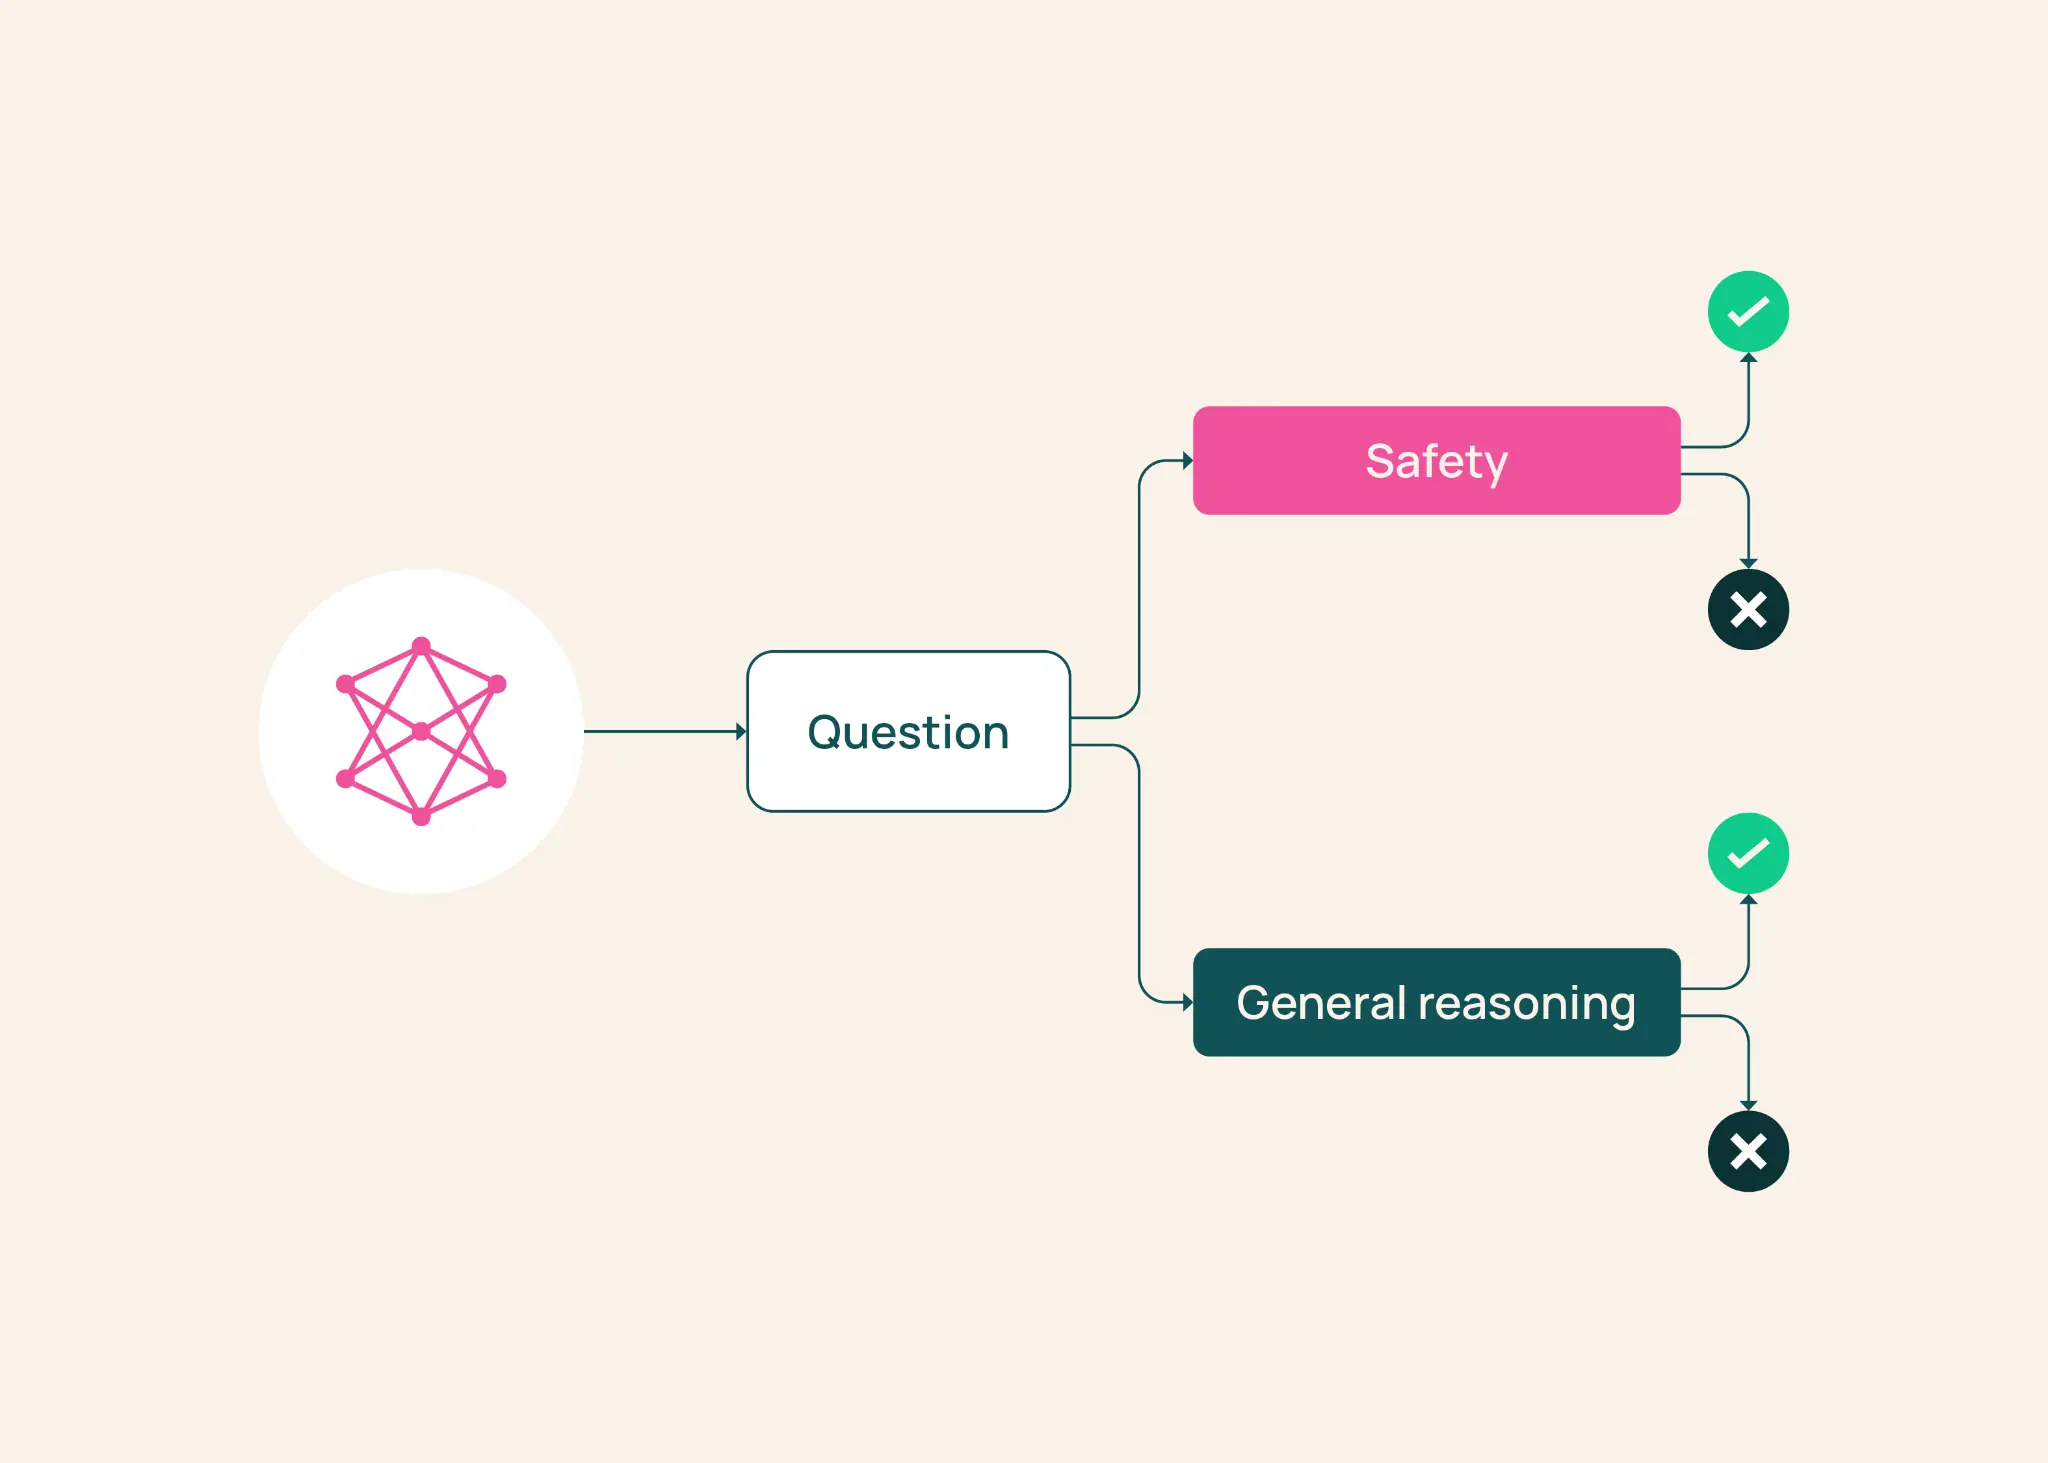
تستند البيانات على نتائج 100 نموذج لغة مفتوحة عبر 16 معيار تقييم يتضمن أكثر من 34 ألف سؤال. استخدمت الأداة تقنية نظرية الاستجابة للفقرة متعددة الأبعاد المستعارة من علم القياس النفسي. وبدون إخبار الأداة عن الهدف المقصود من كل اختبار، اكتشفت بشكل مستقل بُعدين أساسيين: الأمان والاستدلال العام.
كشفت BenchMIRT عن حقائق معقدة حول ما تقيسه الاختبارات الحالية. فمثلاً، اختبار BBQ الذي يقيس الانحيازات الاجتماعية ارتبط بقوة أكبر بقدرات الاستدلال العام بدلاً من السلوك الآمن وحده. وعلى نحو مماثل، وجدت الأداة أن اختبار HarmBench يمزج إشارات مختلفة: بينما ترتبط معظم أسئلته بالأمان، فإن أسئلة حقوق التأليف والنشر فيه ترتبط أكثر بالاستدلال العام.
توفر الأداة فائدة عملية إضافية: يمكنها التنبؤ بأداء نموذج على أسئلة لم يجب عليها من قبل بدقة تصل إلى 79 في المائة. كما اكتشفت أن الاحتفاظ بـ 10 في المائة فقط من الأسئلة الأكثر تمييزًا يحافظ على صورة دقيقة تقريبًا عن نقاط قوة وضعف النماذج.
مع ذلك، اعترفت المنصة بقيود مهمة. النماذج المستخدمة في التطوير كانت جميعها مُطلقة قبل مارس 2025، والأبعاد المكتشفة تعتمد على مجموعة الاختبارات المختارة. كما تنطوي الأداة على مخاطر محتملة حيث يمكن استخدام تحليلها التفصيلي لإضعاف الاختبارات بدلاً من تحسينها.



Comments (0)
No comments yet. Be the first.