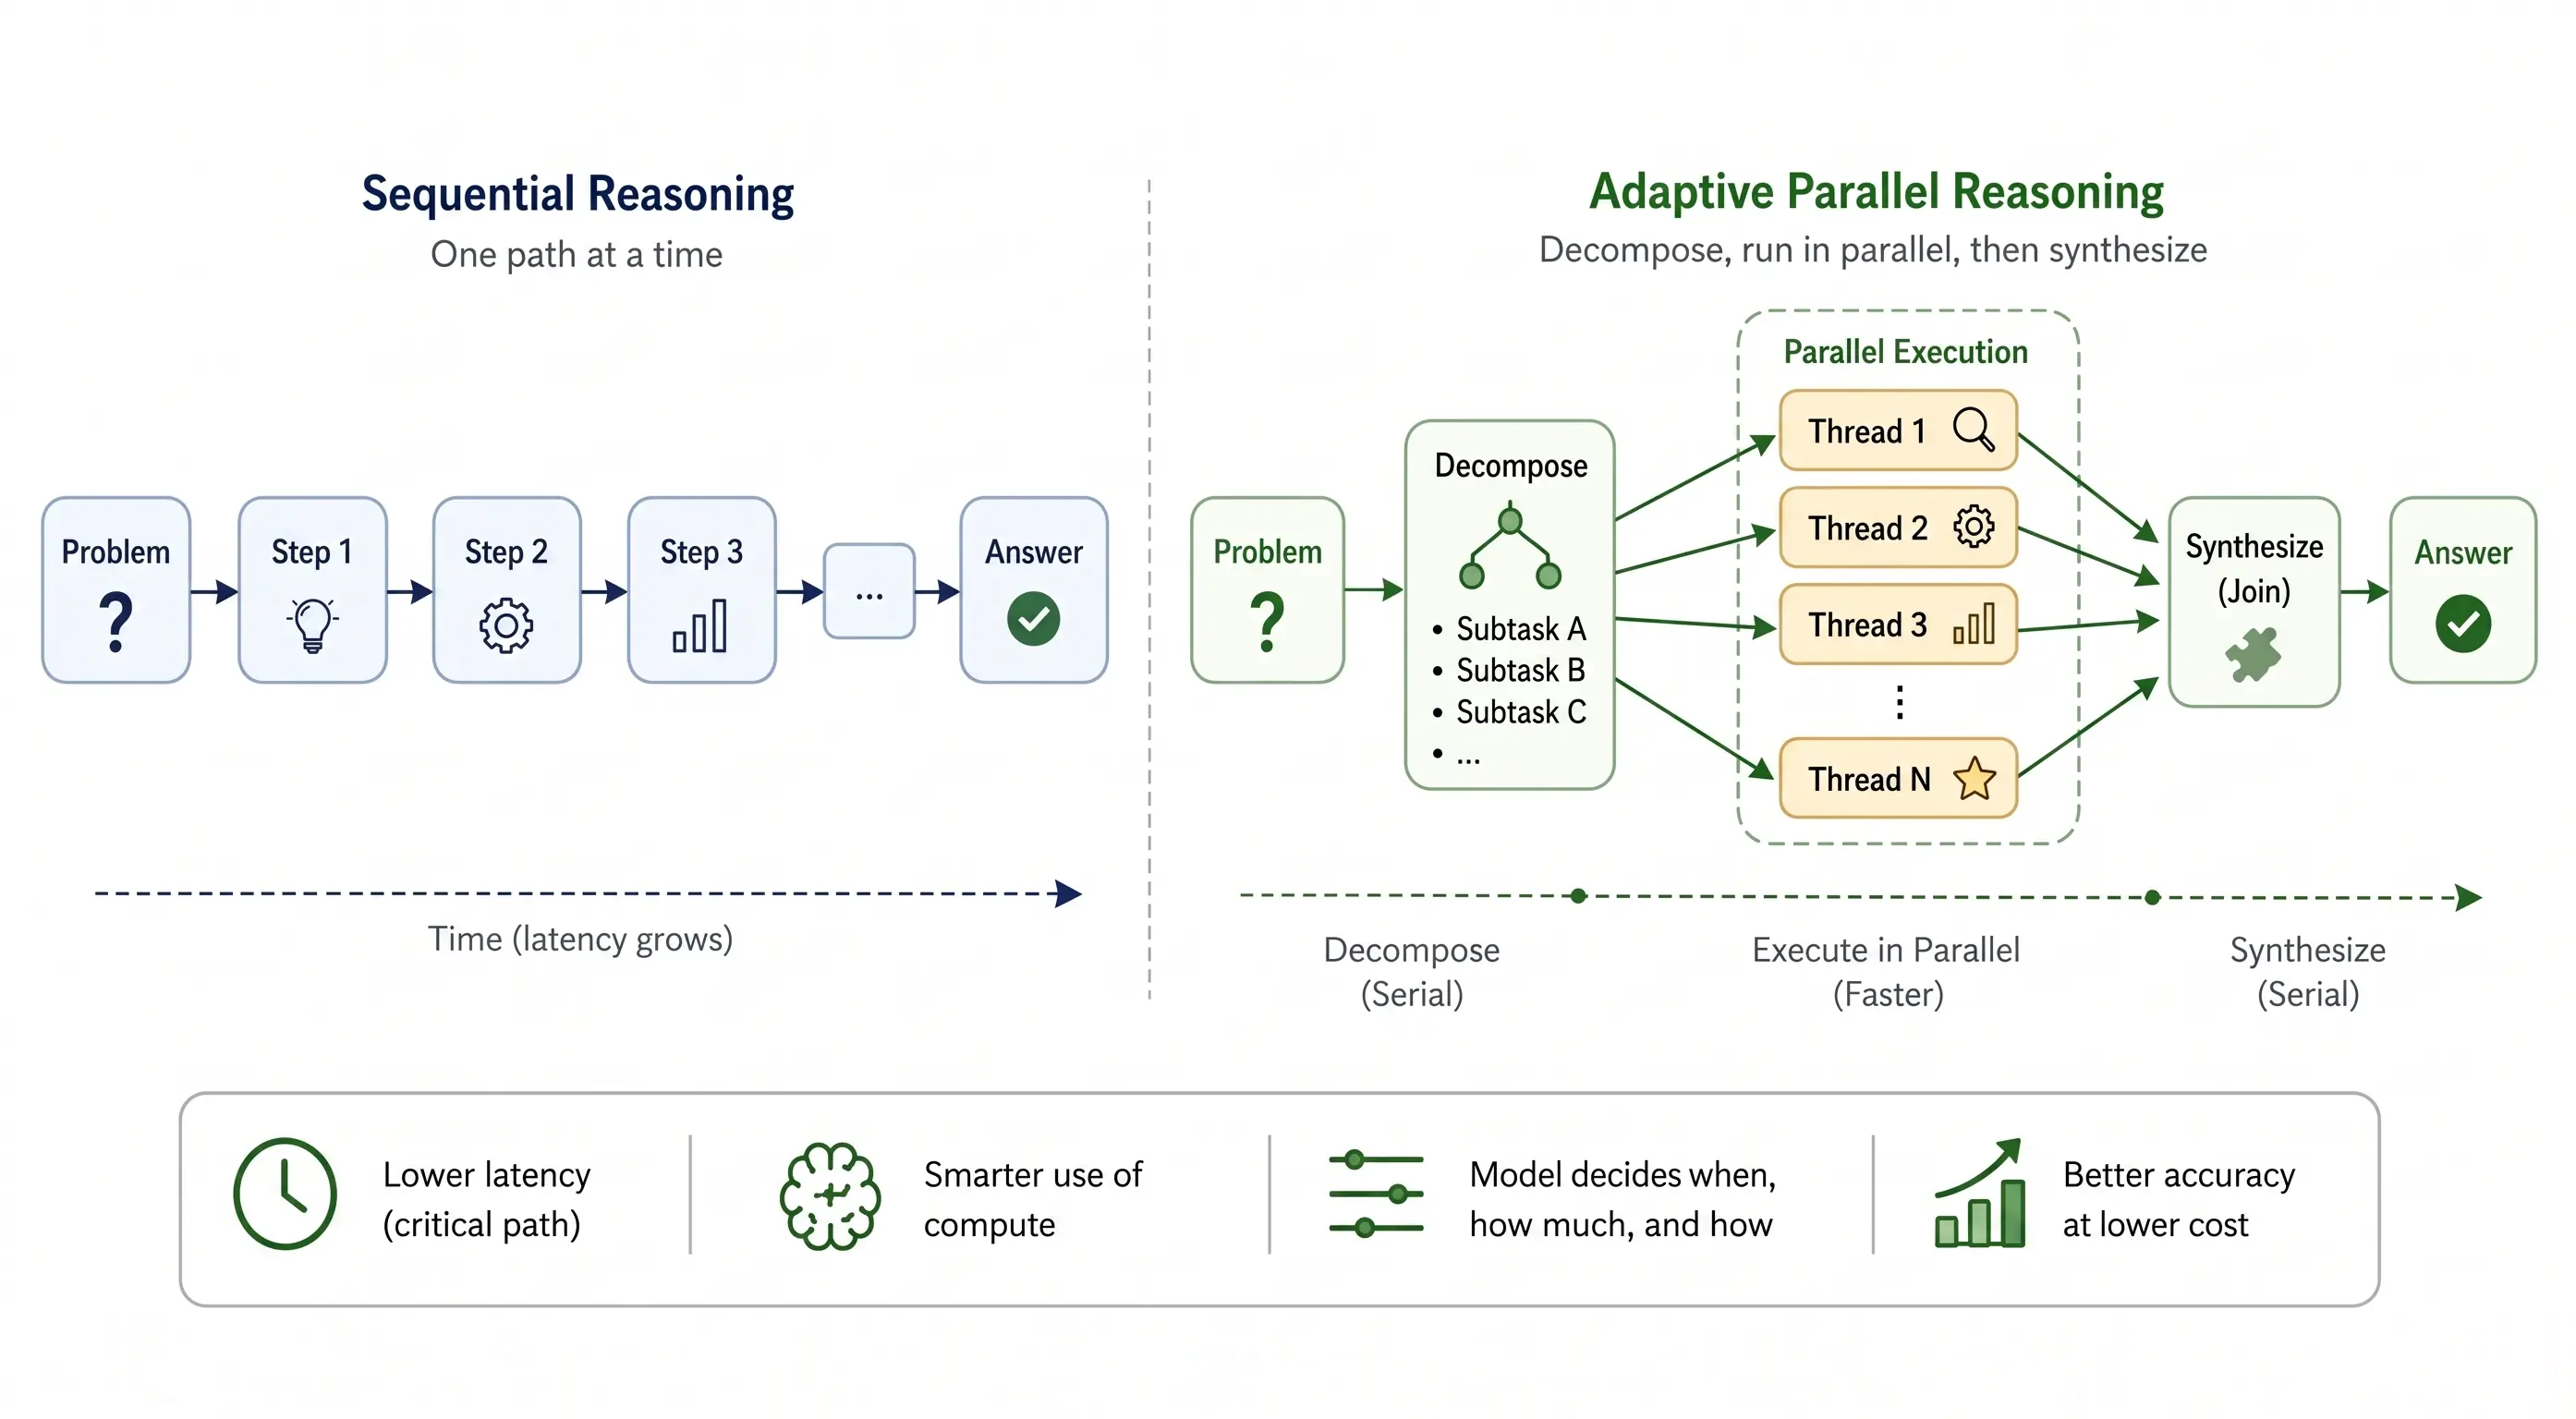
تواجه نماذج اللغة الكبرى تحديًا متزايدًا: كلما زاد الاستكشاف التسلسلي للحلول، ازداد عدد الرموز المستخدمة وطول السياق، مما يؤدي إلى تدهور الأداء وتأخير شديد قد يصل إلى ساعات في المسائل المعقدة. الحل التقليدي هو المعالجة المتوازية، لكن الأساليب الموجودة تفرض هيكلًا متوازيًا واحدًا على جميع المسائل بغض النظر عن احتياجاتها الفعلية.
يقدم باحثو مختبر الذكاء الاصطناعي بجامعة بيركلي نموذج الاستدلال التكيفي، وهو نموذج يتعلم بنفسه متى يقسم المسألة إلى عمليات متوازية وكم عدد المسارات المستقلة التي يجب فتحها. بدلًا من تطبيق نفس الاستراتيجية على كل المسائل، يكتسب النموذج سلوكًا تكيفيًا من خلال التعليم بالتعزيز، مما يسمح له باكتشاف أنماط متوازية مفيدة لم يكن ممكنًا تصميمها يدويًا.
يتفوق هذا المنهج على الأساليب السابقة بثلاث طرق: لا يحتاج إلى إرشادات محددة حسب المجال لتقسيم المسائل، ويتجنب الحسابات الزائدة بالسماح للنموذج بالتحكم في محتوى كل مسار قبل تفعيله، والأهم أنه يمكنه الامتناع عن المعالجة المتوازية تمامًا عندما لا تكون مفيدة.
تقنيًا، يطبق النموذج هذا بإصدار رموز خاصة تتحكم في نمط الاستدلال، وعند التنفيذ يستخدم معمارية الفرع والالتحام من علوم الحاسوب. يعالج الباحثون تحديًا تقنيًا مهمًا حول إعادة دمج ذاكرة الـ KV Cache من المسارات المتوازية، وقدموا حلولًا متعددة مثل استخدام تقنية RadixAttention وتعديل محركات الاستدلال لإعادة استخدام الذاكرة بكفاءة.
تمثل هذه الطريقة تحولًا نموذجيًا في كيفية توسيع قدرات الاستدلال: بدلًا من فرض هيكل ثابت، يُترك للنموذج القرار بناءً على طبيعة المسألة، مما يحقق توازنًا أفضل بين سرعة المعالجة والموثوقية والكفاءة الحسابية.



Comments (0)
No comments yet. Be the first.