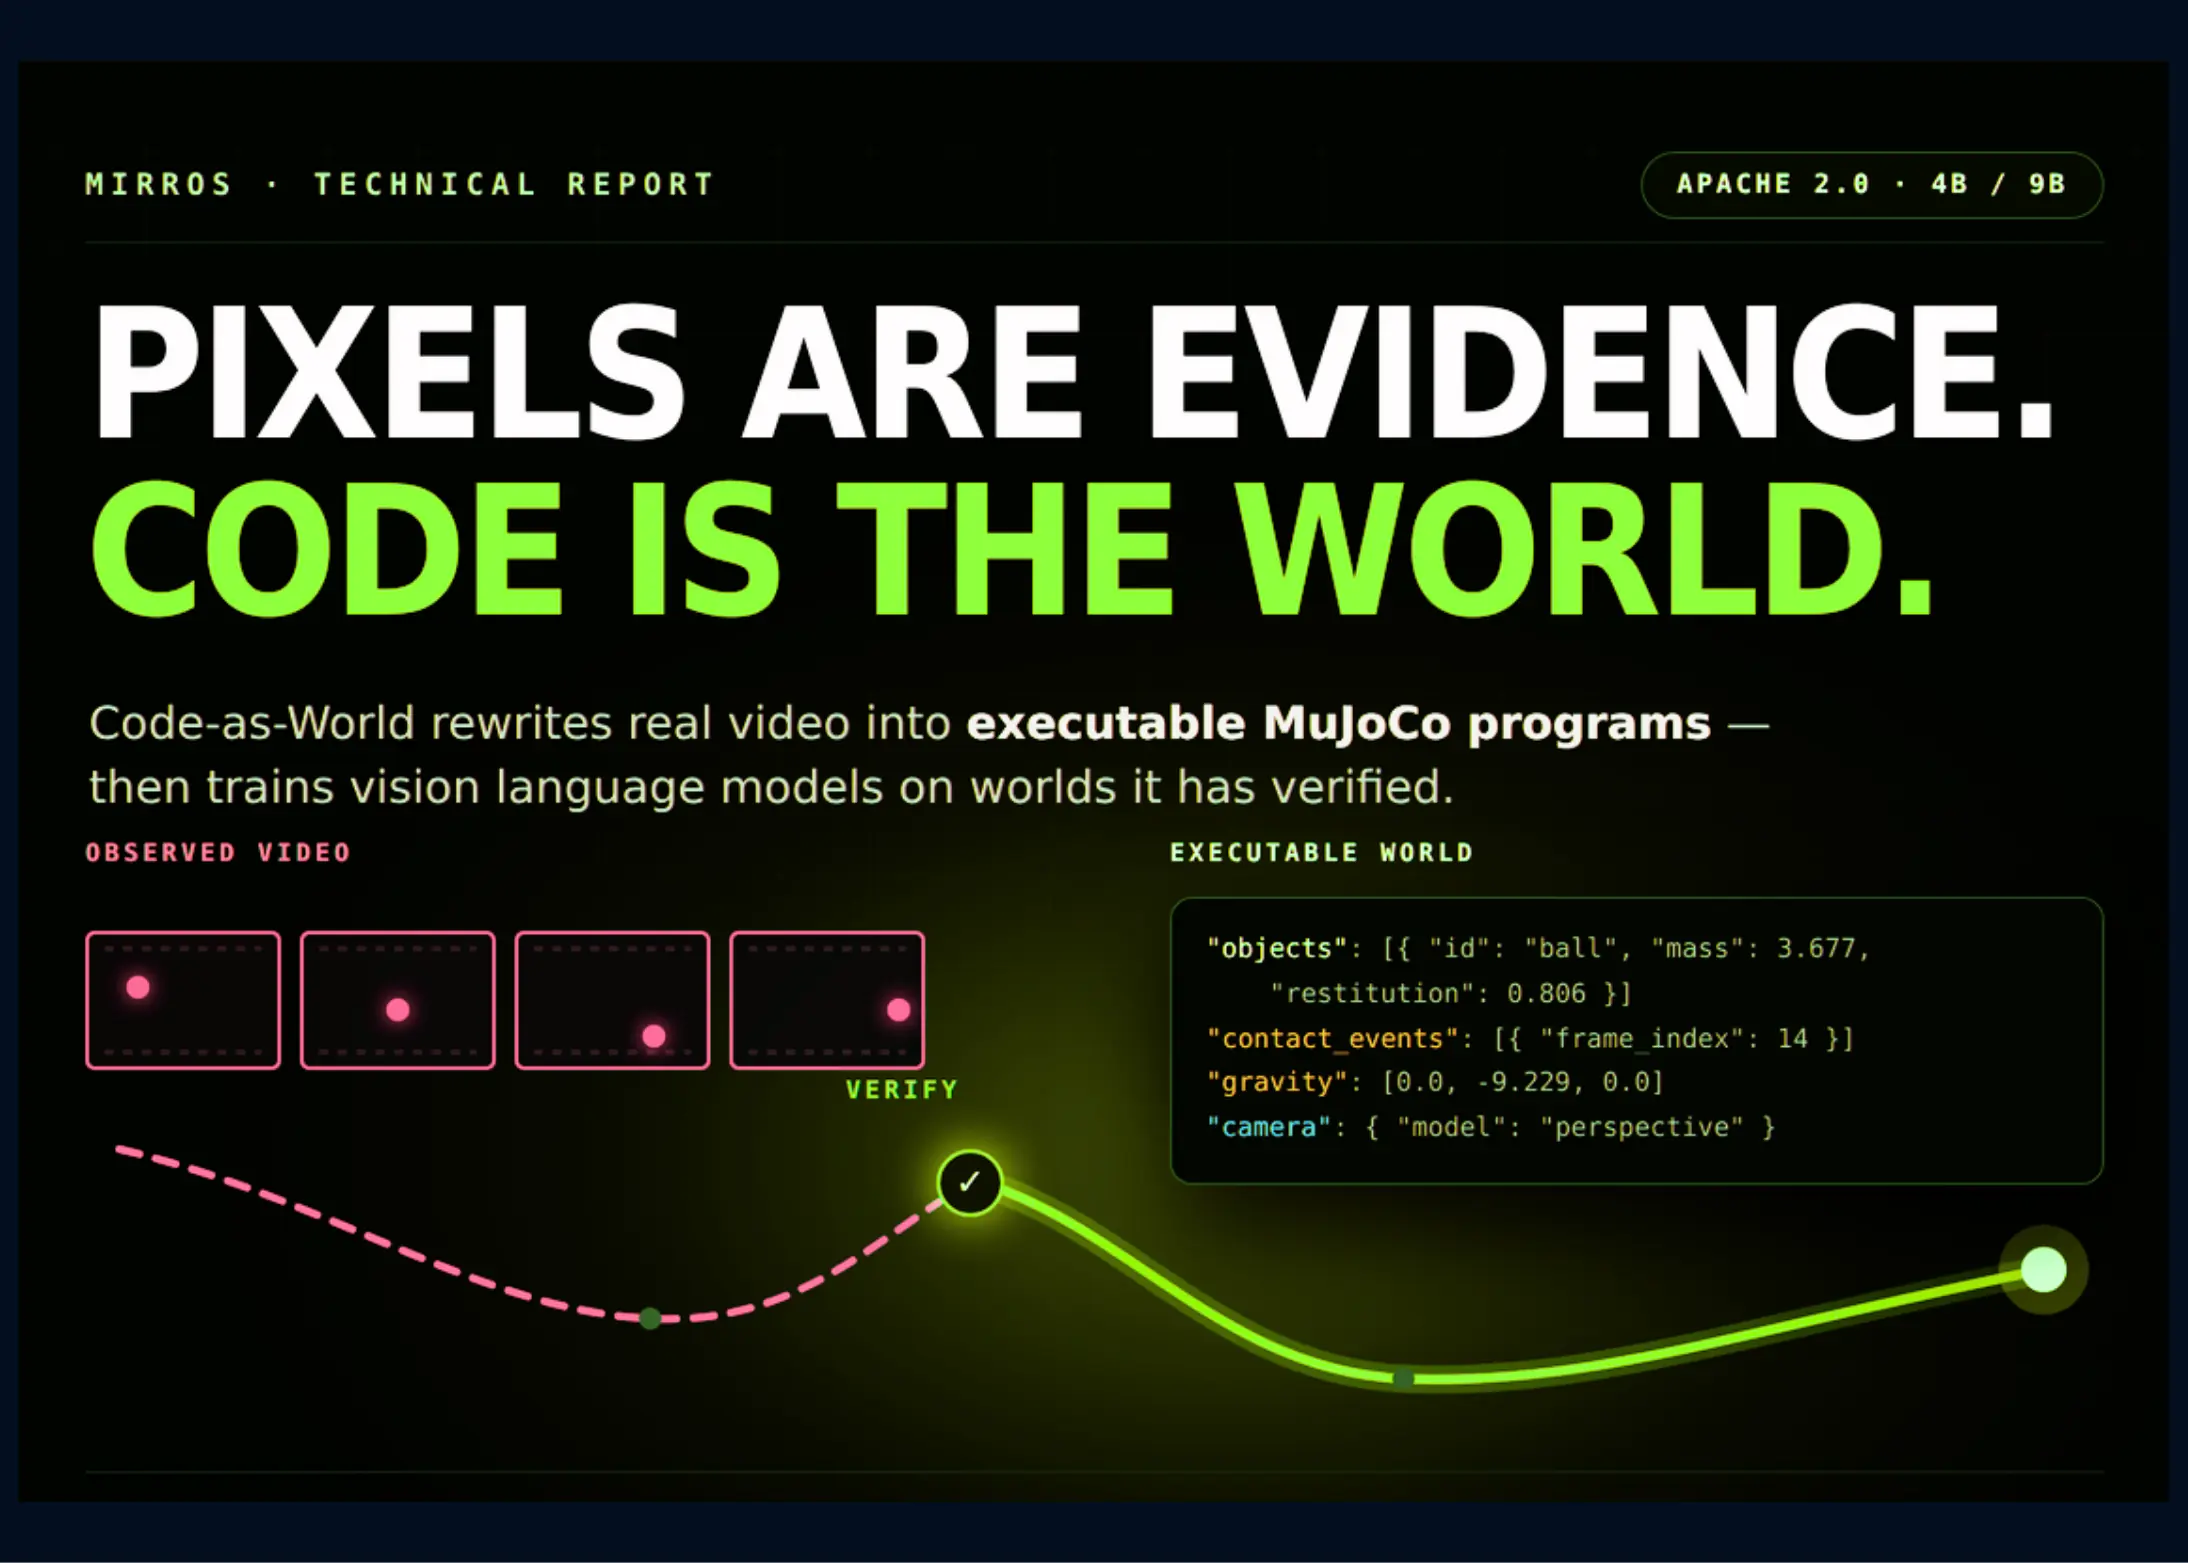
أطلقت شركة MirroS نموذجًا جديدًا يعيد تصور طريقة فهم الأنظمة الذكية للمشاهد الفيزيائية من خلال تحويل لقطات الفيديو إلى برامج قابلة للتنفيذ. بدلًا من الاعتماد على البيكسلات أو التمثيلات الكامنة، يمثل النموذج المشهد كملف scene.json قابل للتشغيل في محرك MuJoCo للمحاكاة الفيزيائية، يمكن للعملاء التحقق منه مقابل الفيديو الأصلي وتعديله وإعادة محاكاته.
يعتمد النموذج على حلقة وكيل ذكي تسترجع هذه البرامج من لقطات حقيقية عبر خمس جولات متتالية من الاقتراح والتحقق والتعديل. تصبح العوالم المثبتة بعد ذلك بيانات تدريب مصحوبة بتسميات فيزيائية دقيقة، وهو ما لا توفره مقاطع الفيديو الحقيقي. حقق النموذج Code-as-World-VL-9B درجة 55.4 على معيار QuantiPhy، متفوقًا على Gemini-3.1 Flash الذي سجل 54.8.
أطلقت MirroS نسختين من النموذج تحت ترخيص Apache 2.0، الأولى بـ 4 مليارات معامل والثانية بـ 9 مليارات، مع ضبط دقيق من نماذج Qwen3.5. يعمل النموذج خلف نقطة نهاية متوافقة مع معايير OpenAI، معالجًا 16 إطارًا مأخوذًا من كل فيديو.
يقوم نظام الاسترجاع باستخدام عدة أدوات متقدمة لتحليل الفيديو وإعادة البناء، منها SAM 3 لتحديد الأقنعة وتتبع الحركة، وVGGT-Omega لتقدير العمق والهندسة الكاميرية. تُقارن مخرجات النموذج مع الفيديو الأصلي على مستويات متعددة بما في ذلك الألوان والعمق والقناع وتسلسل الحركة.
مرّ التدريب بمرحلتين: الأولى ركزت على مطابقة الصور باستخدام 73 ألف زوج أسئلة وأجوبة، والثانية طبقت تعليمًا معززًا على أساس العالم الفيزيائي باستخدام 1585 عالمًا نصيًا و988 عالمًا مستخرجًا من الفيديو. استخدم التدريب ثماني معالجات NVIDIA H100.
في الاختبارات المقارنة على معيار QuantiPhy، تفوق النموذج بـ 9 مليارات معامل على ChatGPT-4.1 الذي سجل 48.4 وعلى أقوى نماذج مفتوحة المصدر Qwen3-VL-32B-Instruct الذي حقق 40.2 فقط. أظهرت الاختبارات أن إضافة بيانات عالم فيزيائي للتدريب رفعت الأداء بنحو 5 نقاط مقارنة بالنماذج التقليدية القائمة على البيكسلات وحده.



Comments (0)
No comments yet. Be the first.