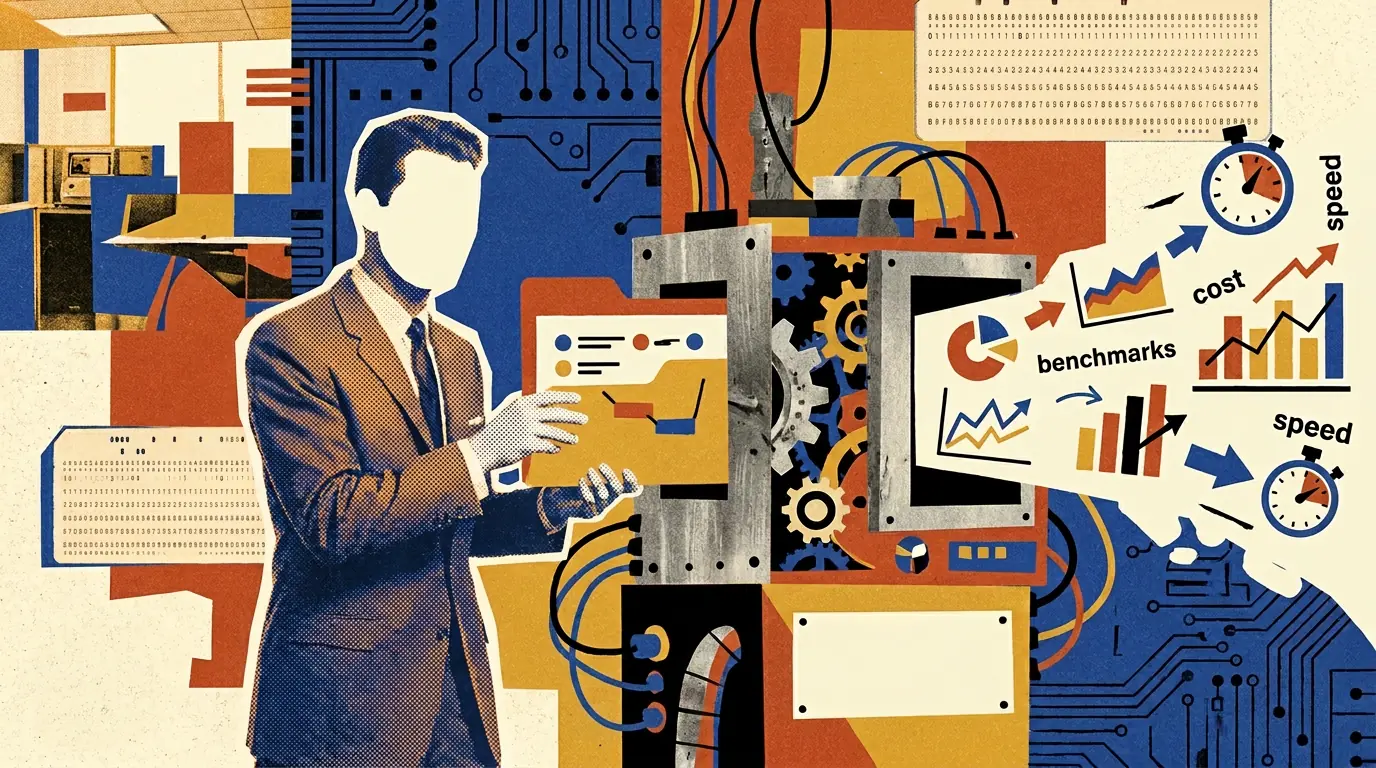
أطلقت شركة Artificial Analysis، المتخصصة في تقييم نماذج اللغة الكبيرة بشكل مستقل، منصة جديدة تحمل اسم Optima تركز على سد فجوة واضحة في تقييم الذكاء الاصطناعي. المعايير العامة المتاحة حاليًا توازن نماذجًا على مهام موحدة، لكنها لا تحدد بالضرورة أي نموذج يناسب احتياجًا محددًا للمستخدم.
تتيح Optima للمستخدمين بناء معايير تقييم خاصة باستخدام بياناتهم وسير عملهم أو وصف حالة الاستخدام المطلوبة، ثم تشغيل هذه المعايير على النماذج الرائدة الحالية ومقارنة النتائج من حيث الجودة وتكلفة المهمة ووقت تنفيذها. تقبل المنصة أنواعًا متعددة من مصادر البيانات منها ملفات التقييم الموجودة أو من منصة Hugging Face، كما تقبل بيانات وكلاء الذكاء الاصطناعي من منصات مثل Arize وBraintrust وLangfuse.
للمستخدمين الذين لا يملكون مثل هذه البيانات، توفر Optima خيارًا بديلًا يتمثل في وصف حالة الاستخدام المقصودة وتقديم عينات من المدخلات والمخرجات، فتقوم المنصة بإنشاء اختبارات مقترحة ومعايير تقييم ومهام نموذجية يمكن للمستخدم مراجعتها وتحسينها قبل تشغيل المعيار الفعلي.
توفر المنصة طريقتين للتقييم: التقييم القائم على معايير موضوعية أو المقارنة الثنائية حيث يقيّم المستخدم عينة من الإجابات ويشير إلى الأفضل منها، فتستخرج Optima الترتيب الكامل من هذه التفضيلات. تتجاوز المنصة الجودة الخام لتتابع أيضًا التكلفة والسرعة كأبعاد مقارنة مستقلة، مما يتيح التحقق من كون الأداء الأفضل يبرر التكلفة الأعلى أو وقت المعالجة الأطول.
حاول المختبرون الأوائل بناء معايير لوكلاء التمويل والمحاسبة للعثور على النموذج الذي يخفض التكاليف بمعامل عشرة مرات دون فقد جودة كبير، واختبر آخرون أي نموذج يطابق أسلوب الكتابة القانونية أو يحدد العناصر بدقة في مجموعة بيانات صور ملكية. تفرض المنصة فقط تكاليف الرموز الفعلية المستخدمة دون هامش إضافي، مع رسم تقييم 0.125 دولار لكل معيار تقييم لكل نموذج و0.375 دولار لكل مقارنة ثنائية.
تعالج Optima مشكلة معروفة في معايير الذكاء الاصطناعي. أظهرت دراسة من Epoch AI أن نتائج المعايير تعتمد على تفاصيل التنفيذ نادرًا ما تُفصح عنها، حيث تسبب اختلافات صياغة الأوامر وإعدادات درجة الحرارة في تقييمات مختلفة للنموذج ذاته. أما في معايير الوكلاء مثل SWE-bench فتحديث برنامج التحكم يحدث فرقًا يصل إلى 15 نقطة مئوية. رغم أن Optima تحل مشكلة فشل المعايير العامة في التقاط الحالات المحددة، إلا أن التحديات المنهجية الأعمق في المعايير تبقى قائمة.
Comments (0)
No comments yet. Be the first.